定时任务:分布式锁、补跑、漏跑
对账任务每天 01:00 跑(调度口径见对账那一篇)。应用从单实例扩到双实例做高可用,第二天的对账差异表里,每一笔差异都出现了两遍——两个实例在 01:00 同时触发了 @Scheduled,各跑了一遍对账,各自往差异表里写了一批。
这篇按「多实例部署、按天跑的任务」写;只跑一台的,锁那一节用不上,漏跑和补跑照样要看。
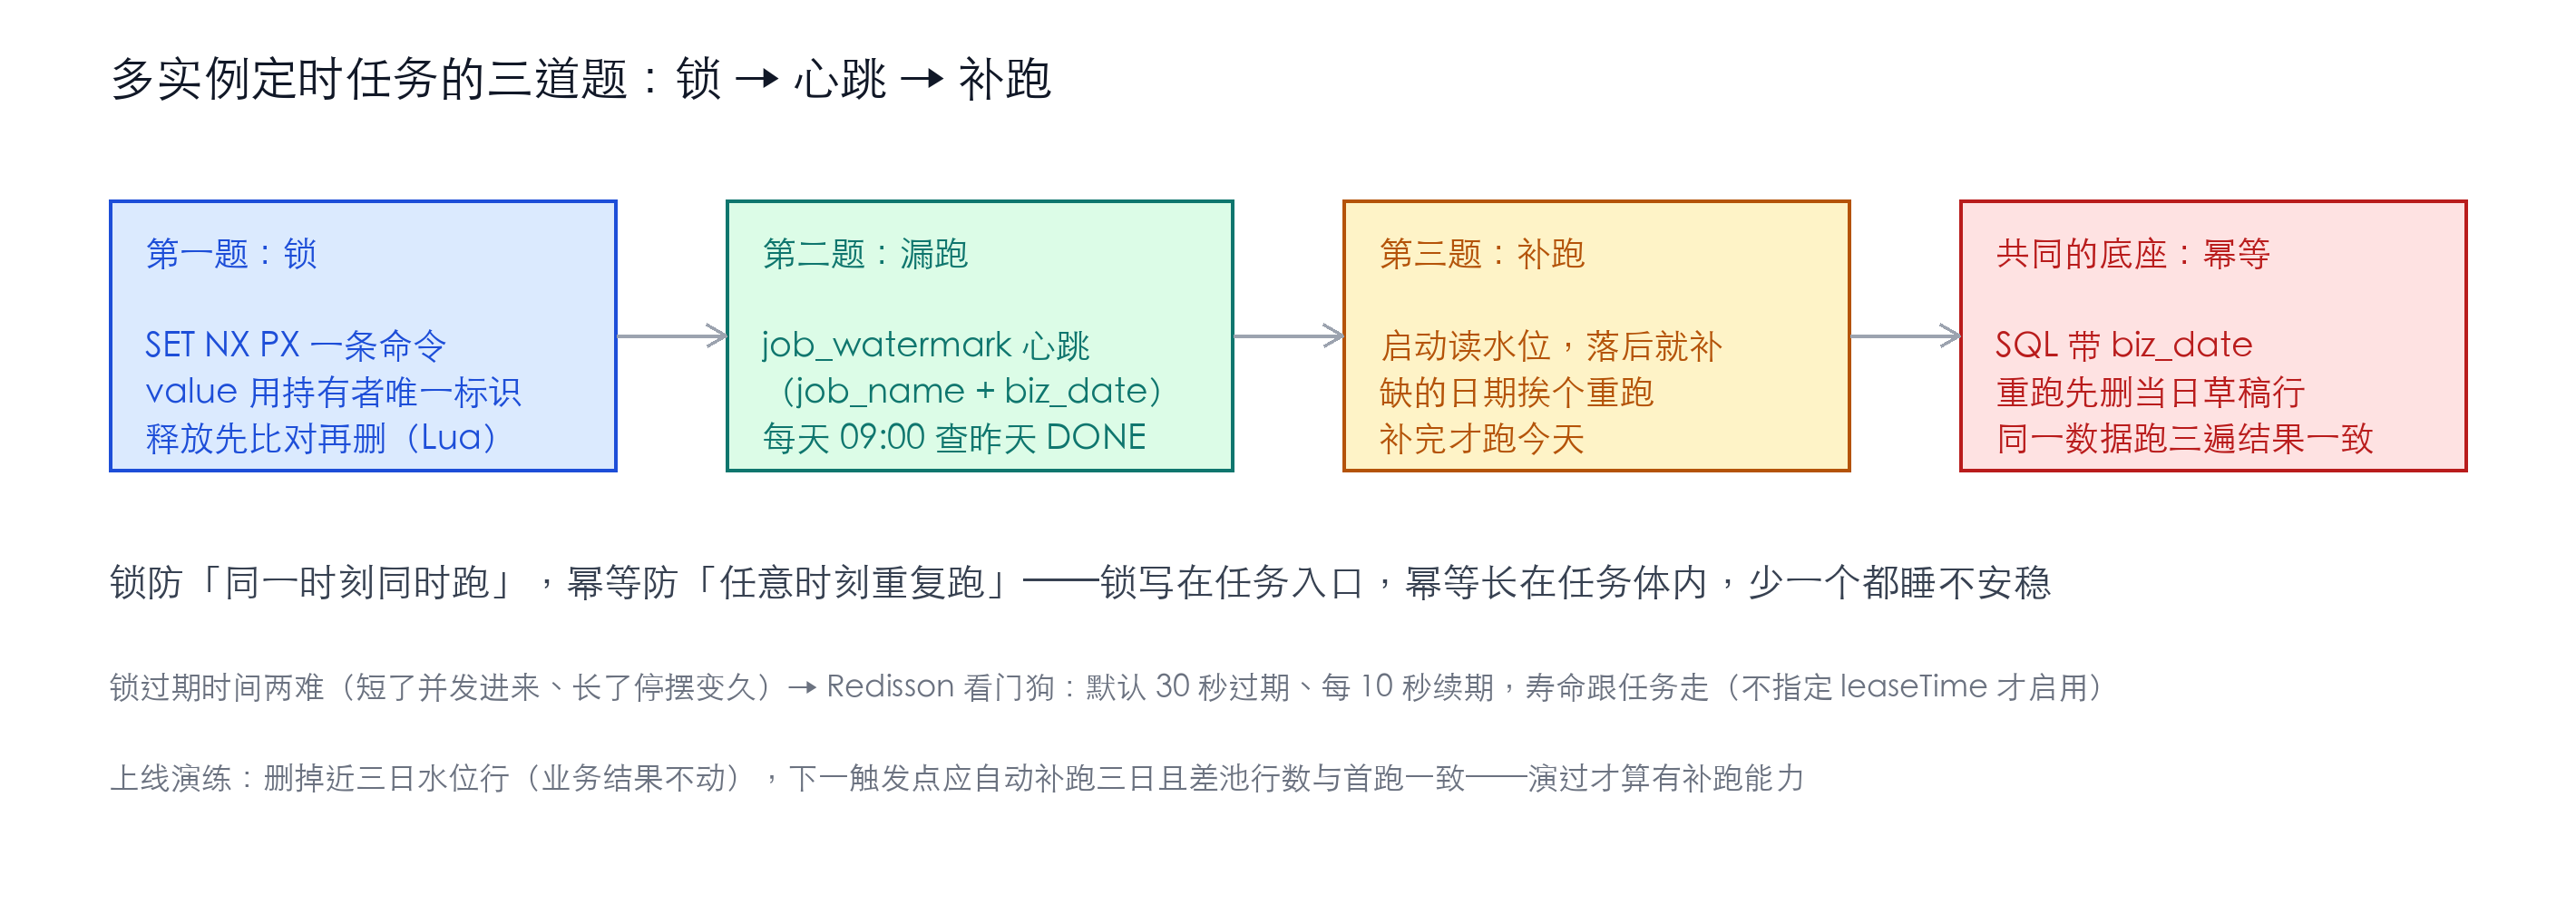
更隐蔽的还在后面。上周三凌晨发了版,发布窗口正好 01:00,那一晚的对账没跑,第二天只好先停当天任务、人工去翻渠道流水补前一晚的数。定时任务在单机上是个注解的事,上了多实例部署就变成三道题:
- 分布式锁:怎么保证同一时刻只有一个实例在跑。
- 漏跑:怎么知道昨晚该跑的有没有跑。
- 补跑:发现没跑之后,怎么把昨天的补回来。
三道题互相独立,也互相配合——锁只管「别同时」,补跑负责「别缺席」,而让补跑安全的幂等(同一份数据跑几遍,结果都一样),从第一道题开始就要铺。
锁只解决一件事:别同时跑
最直接的工具是 Redis 的 SET key value NX PX milliseconds(NX 是 key 不存在才写入,PX 设过期毫秒数——一条命令完成占锁和定时,两个参数缺一不可):
# 拿锁:value 必须是本次持有者的唯一标识(如 实例ID+UUID)
SET job:recon:20261030 i-7f3a-uuid-91bc NX PX 300000

# 释放:先比对 value 是不是自己的锁,再删;Lua 保证两步原子
if redis.call("GET", KEYS[1]) == ARGV[1] then
  return redis.call("DEL", KEYS[1])
else
  return 0
end
Lua 脚本在 Spring 里这样执行(用 StringRedisTemplate,别用挂了 JSON 序列化器的 RedisTemplate——ARGV 是脚本的位置参数,即 KEYS 之外传入的值,挂了 JSON 序列化器会被序列化成带引号的字节,比对永远失败):
var script = new DefaultRedisScript<Long>(
    "if redis.call('GET', KEYS[1]) == ARGV[1] then " +
    "  return redis.call('DEL', KEYS[1]) else return 0 end", Long.class);
Long released = stringRedisTemplate.execute(
    script, List.of("job:recon:20261030"), lockValue);
两个参数各防一种事故。value 用唯一标识,防的是「释放了别人的锁」:实例 A 拿锁、任务跑得久、锁过期、实例 B 拿到锁开始跑,A 干完活执行 DEL——没有唯一标识比对的话,A 删掉的是 B 的锁,实例 C 趁虚而入,锁形同虚设。过期时间防的是「持锁实例宕机后锁永远不释放」:没有 PX,实例 A 崩了没人 DEL,任务从此不再运行。而过期时间本身是个两难:设短了任务没跑完锁先过期,第二个实例照样进来;设长了宕机后任务停摆的时间跟着变长。Redisson 的看门狗机制解这个两难:不手动指定 leaseTime 时,锁默认 30 秒过期,后台线程每 10 秒检查一次,任务还在跑就把过期时间续回 30 秒,任务结束或实例宕机才停止续期——锁的寿命跟着任务走,而不是跟着配置走。
看门狗有三条边界要认清:
- 进程假死:它防的是「忘了续期」,防不了持有者进程本身假死。一次长过 20 秒的 GC 停顿就能让锁先过期(每 10 秒续回 30 秒,停顿开始时剩余有效期最少只有 20 秒),多实例照样进来。
- 重载陷阱:
tryLock(waitTime, leaseTime, unit)这个重载一旦传了 leaseTime,看门狗静默失效(它只在未指定 leaseTime 时启用),这是最常见的踩法。 - 主从切换:Redis 主从异步复制在 failover 时可能整把锁丢掉,那是另一层问题(Redlock 争议的源头),要靠幂等兜底(锁没拦住时,由幂等挡住重复执行),而不是换锁。
用原生 SET NX 也能凑合,把任务拆成幂等的短步骤、每步重新拿锁,复杂一点但少一个组件依赖。
任务没跑,谁先知道
漏跑的来源比想象的多:
- 调度单点:@Scheduled 挂在应用里,应用没起来,调度就不存在。
- 发布窗口:发版正好盖住触发时刻。
- 日期配错:cron 表达式写了每月 31 号,30 天的月份就静默跳过。
这三种的共同点是没有报错,任务就是没发生。发现机制因此不能依赖异常,要依赖「最后一次成功的时间」。调度平台(xxl-job 这类,调度中心负责触发、应用只当执行器)自带这个视图:执行列表里每个任务最近一次的执行时间和结果都在。用了调度中心,Redis 锁从「必需」降级成「兜底」——单播路由本身一次只触发一台执行器,锁挡的是阻塞策略(上一次没跑完、下一次又触发时的处理规则)之外的重叠和手工误触发,两层要不要都上,看漏跑一次的代价。
用 @Scheduled 的,给每个关键任务加一行心跳:任务开头往水位表 job_watermark 写一条 RUNNING(job_name 加 biz_date 定位到某天),结束置 DONE,超过两小时还是 RUNNING 的由回收逻辑置为 FAILED(不用人写)。再配一条最笨的监控:每天 09:00 查「昨天」这行,查不到 DONE 行和查到 RUNNING、FAILED 一样告警——漏跑那晚这行根本不会存在,空行分支最容易漏;检查任务自己也多实例部署时,加锁或让告警端去重。这个检查本身也是定时任务,它自己也可能漏跑,发现它靠的是另一个用不同 cron 的检查——监控链路里别用同一个节拍器。
CREATE TABLE job_watermark (
  job_name    VARCHAR(64) NOT NULL,
  biz_date    DATE NOT NULL,          -- 这次任务处理的是哪一天的数据
  status      VARCHAR(16) NOT NULL,   -- RUNNING / DONE / FAILED
  finished_at DATETIME NULL,
  PRIMARY KEY (job_name, biz_date)
);
补跑靠水位,不靠人记
发现漏跑之后,补跑的动作必须是「重入」(任务自己从断点接着跑)而不是「人肉重放」。水位表在这里就是断点:任务启动时先读自己的水位,最新 DONE 的 biz_date 落后于今天,说明中间有日子没跑,循环把缺的日期挨个补上,补完才跑今天。两个边界要定死:
- 首次上线:水位表一行都没有时,从配置的起点日期开始,并设回补上限(比如最多回补 30 天);裸实现会一路追跑到建库之日。
- 日序依赖:对账 T 日的核对依赖 T-1 的结果,补跑遇到第一个失败日就停,剩下留给下一个触发点续跑,别跳过失败日硬往下补。
补跑的触发时机是下一次调度触发——日任务意味着最多再等 24 小时;想做到「应用一起来就补」,加一个启动触发器(ApplicationRunner 抢到锁后跑同一个任务入口),两种都要,代价是多一段启动逻辑。还有一句丑话说在前面:补跑的前提是源数据可回拉——渠道账单接口一般保留三个月(对账那一篇的口径),缺几天补几天没问题;哪种渠道只给当天流水的,先把回拉窗口谈下来,谈不下来补跑就是无米之炊,开头那种漏跑就只能靠人工。这个设计让漏跑的修复时机从「有人发现」变成「下一个触发点自动执行」,发布窗口、宕机、调度器故障造成的缺口,都在恢复后自动合拢。
补跑安全的全部前提是幂等:对账任务的批次幂等按对账那一篇的做法来(按 batch_id 先清当日草稿再重算,差异行带人工处理状态的要结转不删,清了就是把同事正在核查的记录抹掉),同一份数据跑三遍结果一致,补跑才敢自动执行。锁和幂等的关系到这里看得清楚:锁防的是同一时刻的并发,幂等防的是任意时刻的重复,两者都齐了,多实例部署的定时任务才真正让人睡得着觉——锁写在任务入口,幂等长在任务体内,少一个都不行。
上线前演一遍补跑
上线前过四件事:
- 锁标识:value 是不是每次持有者唯一,释放是不是先比对再删。
- 过期时间:和任务最坏时长的关系算过没有,长任务有没有上续期或拆步。
- 每日检查:水位表有没有配「昨天是不是 DONE」的检查,检查用的 cron 和业务任务错开。
- 演练补跑:真演练一次,不是想象一遍。
DELETE FROM job_watermark WHERE biz_date >= CURDATE() - INTERVAL 3 DAY删掉近三日水位(业务结果表不动),下一个触发点应当自动补跑三日;验收断言两条——补跑后三日的水位全为 DONE,差异表当日行数与首跑一致(多了少了都说明幂等没闭合)。
演过一遍的系统,才算有补跑能力。
系列:相关 对账:三方核对的最小实现 | 线上出问题,先分清是所有人都慢还是一个人慢 | 技术纵深系列索引