账不平时要能说出错在哪一层
上一篇那笔 128 元进了账,每一步看起来都对,只有月底拿银行到账一对,才知道少了 74 分。先把这笔 128 元放回账上,看它还能怎么错。
钱收了,订单推进了,核销时分账凭证两边相等,11,827 分进了门店的可提现。第二天渠道把这笔结出来,到账 12,726 分。差的 74 分是渠道实际收的手续费:你的分账公式按 0.6% 预估了 77 分,账单回来是 74,07 那篇为此补了一张 FEE_TRUE_UP。
现在假设那张凭证没人补。业务侧看不出问题:渠道账单里有这一笔,交易金额换算过来是 12,800 分,你的订单里也是 12,800,单笔比对干干净净。分账凭证也看不出问题:它的 IN(进账)和 OUT(出账)两个方向仍然相等,手续费那 77 分本来就记进去了。只有拿银行到账去对分录,缺的那 74 分才露头。
这类错误不在“有没有掉单”这一层,它在记账那一层。06 对付的是掉单和重复支付,那一层做得再好也管不到它。
对平了两边,还能错在第三边
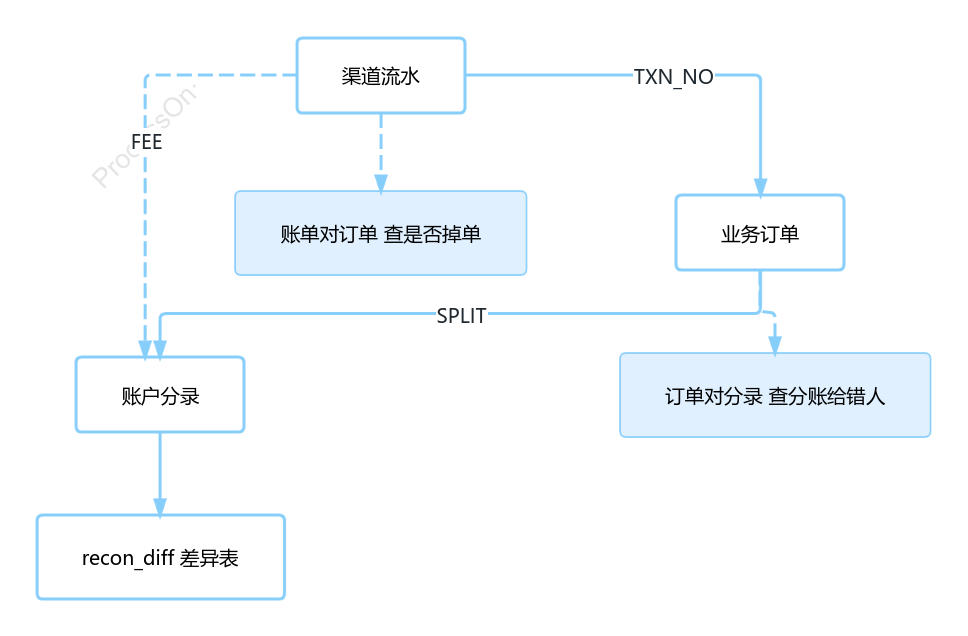
三份数据各有各的口径,也各有各的错法。渠道流水是外部凭证,按渠道自己的归集时间切一天,金额单位是元,退款和结算费用可能在另一个文件里。业务订单是你自己的事实,记的是“这单付过了”,它不关心钱最后到谁的账上。账户分录是 07 那篇建的三张表,记的是“这笔钱被分给了谁”,它的正确性由凭证内部两边相等保证,跟渠道无关。
账务里管这三份数据两两对上叫勾稽,每一对查的是一种错。账单里的流水号和库里的支付记录对上,问的是这笔钱到底收没收、有没有收两遍。订单和分录对上,问的是收了钱的单子入账了没有、入给了正确的主体没有。最难想起来的是账单直接对分录那一条,手续费、结算口径、分账比例都在这里,而它们全都不进业务订单。
最好写的那条恰好是信息量最小的一条:拿账单的商户订单号去库里查一遍就完事,很多系统只接了这一条。剩下那两条通常要等出事才补,出事的时候一般已经错了半个月。
落地顺序按代价来。渠道流水是唯一不在你库里的一边,先把它拉进来落成表;订单对分录这条,大部分能靠已有字段查出来;轮到分录那条等式,前提是分录这套已经在跑,它还没做,那条等式就无从谈起,那就先把流水和订单这两边对稳。
账单文件拿到手之前,事最多
拉账单的接口不长。微信调 GET /v3/bill/tradebill 传 bill_date(account_type 按你要对的资金户传,默认是基本户),返回一个 download_url 和文件的哈希类型、哈希值;支付宝调 alipay.data.dataservice.bill.downloadurl.query 传 bill_type 和 bill_date,返回 bill_download_url。麻烦都在这一步之后。
下载地址的时效按秒算,两家文档给的都是 30 秒(以你接的那个版本为准,反正都撑不到下一轮)。拿到 URL 必须立刻下载,重试要重新申请一次地址;把 URL 存进任务参数里等晚点再用,几乎一定失败。这个失败还会伪装成“账单文件不存在”,因为接口报错和文件还没生成在你库里会长成同一个日志行。
生成时间也是一条硬约束。微信的昨日账单要当天十点以后才有,支付宝的日账单一般次日九点前生成,且明确不支持当日。两边的定时任务不能挂在同一个整点,早挂的那些会拿到“账单不存在”,然后被写成一次正常空跑。区分“还没生成”和“当天真的没有交易”,靠接口错误码加上当天有没有成功流水,不能靠文件行数;区分的结果也要落库,状态里给 NO_BILL 单独一个值,它和 FAILED 第二天要是长成一个样子,这个区分就白做了。
能补多久以前的账,两家给的答案不一样。微信的账单接口只能取三个月内,支付宝的日账单能取到近六年。别把“历史随时能重放”写进代码的前提里——你重跑半年前那一批的时候,微信这条路是死的。原始行落了库是另一回事:库内重放不受这个限制,受限的只是重新拉文件。
文件的形态更别指望统一。微信的交易账单分四段:明细表头、明细内容、汇总表头、汇总内容,字段用逗号分隔。它又按 bill_type 分成 ALL、SUCCESS、REFUND 三种,三份文件的明细表头字段数量、顺序都不一样,只有 ALL 里同时有支付和退款行。
明细里每个字段前面还挂了一个反引号,那是防着 Excel 把长单号显示成科学计数法用的,解析时要去掉,不然金额和单号会带着这个字符进库。
支付宝给的是一个 zip,里面按业务账单和财务账单分目录,每个目录里各有明细和汇总两张表,编码不是 UTF-8(具体是哪一种,拿到文件先确认再写解析器,别信任何二手说法)。
所以解析器要按列名取,不能按列序号取,而且读完表头先断言一次:列名集合和期望一致、列数一致。换了 bill_type、或者商户开通了某个产品导致账单格式从早期版本切到新版(早期账单没有“应结订单金额”这一列,只有总金额),出了问题也不会报错,只会读错列。
单位换算必须发生在解析的那一刻。微信账单里的金额字段单位是元、保留两位小数,而你接口侧存的是分:这一笔在账单里是 128.00,在库里是 12,800。06 说过除错一次是一百倍,这里是同一个坑换了个入口。换算漏一次,整个匹配环节全报“金额不符”,这种满屏的差异出来不到两天,就没有人再信这张表了。
拿到文件先算哈希,跟接口返回的 hash_value 比。不一致就重取。私有化部署时中间那台代理会不会动内容你不知道,而“文件看着正常但少了三百行”的代价比一次重试高得多。
汇总是单独一段,别把它当明细。倒数第二行是统计标题、最后一行是统计数字,按固定行数读或者显式跳过都行,读成一笔订单就糟了:那行会带着一个几百块的“应结订单总金额”进到明细里,而它在任何一侧都配不上对。
服务商模式下还有一个容易漏的地方。微信的 sub_mchid 不填返回全量子商户,填了只返回那一家。很多系统按子商户循环拉取,然后漏掉新签的那一家,因为循环用的是一份手工维护的清单。这份清单必须是 pay_merchant 里 status = 'active' 的那些行,别放配置文件,07 那篇讲过为什么。
汇总行和明细行先进库,原始那一行也进
渠道那一边要落成两张表。业务订单和账户分录本来就在你库里,缺的是把账单装进来、并且让重跑有地方落。一个批次一行,重跑靠它。
CREATE TABLE recon_batch (
  id                BIGINT      NOT NULL AUTO_INCREMENT,
  channel           VARCHAR(16) NOT NULL,   -- wechat / alipay
  mch_id            VARCHAR(32) NOT NULL,
  sub_mch_id        VARCHAR(32) NOT NULL DEFAULT '',  -- 服务商模式下的子商户,直连填空串
  bill_date         DATE        NOT NULL,
  bill_type         VARCHAR(16) NOT NULL,   -- trade / fund / book,两个账单文件不混
  file_hash         VARCHAR(64)     NULL,   -- 接口给的 hash_value
  file_hash_ok      TINYINT     NOT NULL DEFAULT 0,
  total_cnt         INT             NULL,   -- 汇总行声明的笔数
  total_amount_cent BIGINT          NULL,   -- 汇总行声明的金额,换算成分
  parsed_cnt        INT             NULL,   -- 明细实际解析出来的行数
  matched_cnt       INT             NULL,
  diff_cnt          INT         NOT NULL DEFAULT 0,
  auto_fixed_cnt    INT         NOT NULL DEFAULT 0,  -- 当日已自动处置笔数,按商户熔断用
  status            VARCHAR(16) NOT NULL,   -- FETCHED / PARSED / MATCHED / DONE / FAILED / NO_BILL(渠道确认无交易,和 FAILED 分开)
  err_msg           VARCHAR(255)    NULL,
  started_at        DATETIME    NOT NULL,
  finished_at       DATETIME        NULL,
  PRIMARY KEY (id),
  UNIQUE KEY uk_batch (channel, mch_id, sub_mch_id, bill_date, bill_type)
);
total_cnt 和 parsed_cnt 留着就是为了让解析器无处可藏。渠道在文件的汇总段里自己说了它有多少笔、多少钱,你解析出来数一遍,比它少就是漏了行。漏一整类行最麻烦:少读了所有 REFUND 行、或者某个币种的行被过滤掉了,差异数看着依然正常,只是账上凭空少了几百笔。06 说要把行数本身当业务指标,落地上就是这两列加一条不等式检查,不需要另外设计一套指标。
uk_batch 里那五列都得是 NOT NULL。sub_mch_id 直连商户没有值,MySQL 的唯一键不约束 NULL,留成 NULL 的话唯一键不拦,同一天同一商户能插进两行,重跑堆出两份批次、两份差异,比覆盖更难清,所以它默认空串。bill_type 进键是因为交易账单和资金账单是两个文件、两个批次,混在一张表里你没法单独重跑其中一个。漏没漏商户,看今天有几行批次,跟 active 的商户数比一下就知道。明细行落到另一张表。
CREATE TABLE recon_channel_flow (
  id              BIGINT       NOT NULL AUTO_INCREMENT,
  batch_id        BIGINT       NOT NULL,
  flow_type       VARCHAR(12)  NOT NULL,   -- PAY / REFUND
  channel_flow_no VARCHAR(64)  NOT NULL,   -- 微信流水号 / 支付宝交易号
  out_trade_no    VARCHAR(64)      NULL,   -- 账单里的商户订单号
  amount_cent     BIGINT       NOT NULL,   -- 元转分之后
  fee_cent        BIGINT           NULL,
  settle_cent     BIGINT           NULL,   -- 应结金额,有就填
  bill_time       DATETIME     NOT NULL,   -- 渠道口径的时间,原样存
  raw_row         TEXT         NOT NULL,  -- 文件里的那一行;商品名长的行可能超 1024 字节
  matched         TINYINT      NOT NULL DEFAULT 0,
  match_rule      VARCHAR(24)      NULL,   -- 用了哪条键配上的:TXN_NO / OUT_TRADE_NO / TIMING_CAND(宽窗候选,不算 matched)
  our_ref_id      BIGINT           NULL,
  PRIMARY KEY (id),
  UNIQUE KEY uk_flow (batch_id, flow_type, channel_flow_no),
  KEY idx_unmatch (batch_id, matched)
);
raw_row 存原文这一行看着浪费,实际是保险。渠道改表头、加列、把日期格式换掉,这些都不会让你的解析器报错,只会让它读错列或者读空。等差异出来,你要能在不看代码的情况下确认“渠道当时给的那行到底是什么”,靠的就是它。
金额那几列存换算后的分,时间那列存渠道给的原样,入库时不做时区转换。转换发生在你算日切窗口的时候,不然原始口径就留不住了。
match_rule 是常被删掉的一列。两个回合都能配上的一对流水,用流水号配上的和用金额配上的,可信度完全不同。三个月后有人问“这单为什么被自动补单了”,这一列是答案。
匹配按能确定的键退下来
匹配就是给两边的记录找到对偶,键的确定性一路往下退。最确定的是渠道流水号。账单里的 channel_flow_no 对上你库里存的 transaction_id,这是 06 那个幂等键的另一半:回调时你按它判重,对账时你按它配对。06 给 pay_notify_raw 建的 uk_pay (channel, transaction_id) 在这里第二次发挥作用,它保证这条 join 是一对一,配上了就是那一条,不用挑。同一个流水号要是出现在两单上,那是要出事的形状,得让它当天就报出来,别在这一步被 join 吃掉一条。
update recon_channel_flow f
  join pay_notify_raw n
    on n.channel = #{channel} and n.transaction_id = f.channel_flow_no
   set f.matched = 1, f.our_ref_id = n.id, f.match_rule = 'TXN_NO'
 where f.batch_id = #{batchId} and f.flow_type = 'PAY' and f.matched = 0;

-- 配上了不等于金额对:同一个流水号、金额不一致的是另一类差异。
-- AMOUNT 这一型全靠这条 SQL 产出,没有它,测试里 seedAmountOffByOneCent 永远是空的
insert into recon_diff
  (batch_id, diff_type, layer, biz_key, our_cent, channel_cent, handle_status, first_seen_at)
select f.batch_id, 'AMOUNT', 'FLOW', f.channel_flow_no, n.pay_amount_cent, f.amount_cent, 'OPEN', now()
  from recon_channel_flow f
  join pay_notify_raw n
    on n.channel = #{channel} and n.transaction_id = f.channel_flow_no
 where f.batch_id = #{batchId} and f.flow_type = 'PAY'
   and n.pay_amount_cent <> f.amount_cent;
流水号配上只是「这笔找到了」,金额等式是另一道闸:回调金额和账单金额不一致的单,上面那条 update 照样把它标成 matched = 1,看起来干干净净,其实差着钱。所以每个回合配完都要再过一次金额等式,不过等式的落成 AMOUNT 差异,不进 matched 的统计。
退一步是商户订单号,用在账单里流水号缺失、或者你库里那笔是查单兜底进来的这种场合(查单走的是另一条路径,pay_notify_raw 里可能没有对应记录)。再退一步是金额加时间窗加主体,这一档不能用来判定“就是这一笔”,只能用来生成候选给人工看,因为同额两笔单落在同一天里太正常了。
每一回合跑完记一次匹配率,写进批次表的 matched_cnt。正常形状是第一回合吃掉九成以上(这是我的经验值,你按自己渠道的基线校准),第二回合再补一小部分,第三回合几乎不动。哪天第一回合掉到七成,问题在数据链路而不在业务,多半是某个商户号的流水存漏了。匹配是双向清账,下面两条查询各管一边。
-- 渠道有、我方无(只算支付行;退款行另走退款单配对,混进来就是每天灌一批假差异)
select count(*) from recon_channel_flow
 where batch_id = #{batchId} and matched = 0 and flow_type = 'PAY';

-- 我方有、渠道这批里没有
select p.id, p.out_trade_no, p.pay_amount_cent, p.channel_txn_id
  from biz_payment p
 where p.channel = #{channel} and p.mch_id = #{mchId}
   and p.status = 'PAID'
   and p.paid_at >= #{billDate} and p.paid_at < #{billDate} + interval 1 day
   and not exists (select 1 from recon_channel_flow f
                    where f.batch_id = #{batchId}
                      and f.channel_flow_no = p.channel_txn_id);
查询里的 biz_payment 就是 06 里 paymentRepo.record(n, o.getId()) 落的那张表,字段名按你自己的叫法换。
还要分清两条查询里的“我方”:配对用的 pay_notify_raw 只证明回调到过,真正的我方是 biz_payment。所以有第三条要查——流水配上了回调、回调背后却没有订单:
select f.id, f.channel_flow_no, f.amount_cent
  from recon_channel_flow f
  join pay_notify_raw n
    on n.channel = #{channel} and n.transaction_id = f.channel_flow_no
  left join biz_payment p
    on p.channel = #{channel} and p.channel_txn_id = n.transaction_id
 where f.batch_id = #{batchId} and f.flow_type = 'PAY' and p.id is null;
这是 CHANNEL_MISSING(渠道有、我方无)在订单层的形状:钱到了渠道、回调也落了库,订单没建出来。双向那两条都照不出它——流水在第一轮就 matched = 1,订单侧的 not exists 只找「有单无流水」。测试里 seedNotifyButNoOrder 种的就是这个形状,产出机制就是这条查询。
几条都空了才算这一批对完。只查渠道侧的系统会把漏单永远留在另一侧那个结果里,没人查它。后一条查询依赖 channel_txn_id 有值,而回调彻底没来、查单也没兜到的那笔,会在这里露出来:两边各有单,就是配不上。
量级上给个可操作的判断。单日二十万笔以内,两侧都进临时表用 SQL 做 join,一条 update 一句,出问题能重放。再往上就按 sub_mch_id 分片跑,并且只把未匹配的集合读回内存。真正不建议的是把整个账单读进一个 Map 逐条比:内存是一方面,更要紧的是出事之后你答不上“这两条当初是怎么被判定成一对的”,而这个问题每次人工核差异都会被问到。
日切口径没定,差异表全是假案
渠道按它的自然日归集账单,你按自己的字段切一天。06 提过晚上十一点五十多的支付会出现在第二天的账单里,那还只是差一天的问题。差一天会自愈,口径对不上是永远对不上的。所以对哪一天,必须是显式入参。
定时任务的参数写成 bill_date = 昨天 没问题,怕的是代码里出现 LocalDate.now() 或者 new Date()。国内渠道都按东八区切日,而容器的基础镜像默认 UTC,客户那台机器是不是 +08 你交付时说了不算。
系统时区差八小时的表现是每天对出一批“渠道有我方无”、第二天又对出一批“我方有渠道无”,两边还是同一批单号,因为窗口整体挪了一天。这种形状靠肉眼很难认出来,靠一条断言兜底。先把 bill_time 存的是渠道哪一列定义死(交易时间还是归集时间),跨日的深夜单本来就合法越界,所以断言写成两段:落在 bill_date 当天的行数占比低于九成九报警,越界行的形态超出 D-1 末尾那几分钟也报警。时区错八小时的话占比直接掉到一半,一定撞在这条断言上。
退款那一边还有一个单独的坑。微信交易账单里的退款行,归集时间是发起退款成功的那一刻,不是退款到账的那一刻,而且官方文档写得很明白:出账之后这一行的状态不再更新。也就是说账单里躺着一条退款记录,不代表用户最后收到了钱,后面它可能失败退回。
账单里的退款行只能当线索,改状态前要拿退款查询接口确认一次,别拿“账单里有”当资金结论。
退款行在匹配里也单独走:flow_type = 'REFUND' 的行按渠道退款单号对 06 那篇的退款记录,配不上的进 STATE(状态不符)去查终态,不进「渠道有、我方无」。上一节的统计和差异生成一律只算 flow_type = 'PAY',少这个过滤,每天全部退款行都会变成“渠道有我方无”,再接上后面那道自动退款,一笔退款就被退两次。
窗口先宽后严。第一遍按 bill_date 前后各放宽一天去查我方记录,命中的那批打上 TIMING 类型挂起来,不进人工队列。T+1 那一轮它们还配不上是正常的,渠道的归集时间本来就滞后;T+3 再跑一次,跨批次把 TIMING 重新匹配一遍,配上了就把状态改成自愈,两边一起关掉。
两个配套要跟上:宽窗命中不动 matched,match_rule 记成 TIMING_CAND(宽窗候选),这样 T+3 才有东西可重配;插 TIMING 差异行之前先查同 biz_key 有没有 OPEN 的 TIMING 行,有就跳过,不然 T+1、T+2、T+3 每轮插一行,人工队列先被它灌满。这样留在人工队列里的才是真差异。
月末那几天要单独看。渠道把 23:59:59 归给这个月,你的库把 00:00:01 归给下个月,一笔钱的归属月就变了,商户按自然月看账单时会说这个数不对。这种差异跟 bug 无关,是口径问题,要提前定:商户账单一律按渠道账单日期出,还是按你的业务时间出,定了就写进文档。07 那张 happened_at 用业务时间的理由在这里又出现一次,两处口径得对上,不然月结永远差几笔。
月结报表怎么出、发票怎么开、多币种怎么记,都要等财务先把口径定下来,代码提前写会白写。跟渠道就结算金额扯皮是另一码事,那是商务动作,工程这边帮不上。
差异表建好,才谈自动处理
CREATE TABLE recon_diff (
  id            BIGINT      NOT NULL AUTO_INCREMENT,
  batch_id      BIGINT      NOT NULL,
  diff_type     VARCHAR(24) NOT NULL,  -- OUR_MISSING / CHANNEL_MISSING / AMOUNT / STATE
                                       -- TIMING / TOTAL / BOOK_UNBALANCED
  layer         VARCHAR(12) NOT NULL,  -- FLOW / ORDER / BOOK,哪条等式报的
  biz_key       VARCHAR(64) NOT NULL DEFAULT '',  -- 单号;TOTAL 类用 TOTAL_CNT / TOTAL_AMT / MISS_MCH:子商户号 做子键
  our_cent      BIGINT          NULL,
  channel_cent  BIGINT          NULL,
  handle_status VARCHAR(16) NOT NULL,  -- OPEN / AUTO_FIXED / INQUIRING / SELF_HEALED / CLOSED
  handler       VARCHAR(32)     NULL,
  resolution    VARCHAR(255)    NULL,
  first_seen_at DATETIME    NOT NULL,
  handled_at    DATETIME        NULL,
  voucher_id    BIGINT          NULL,  -- 处置动作出的那张凭证
  PRIMARY KEY (id),
  UNIQUE KEY uk_diff (batch_id, diff_type, biz_key),
  KEY idx_open (handle_status, first_seen_at)
);
这张表是这套系统的产物,也是它唯一被人看的部分。layer 这一列是它和普通差异表的区别。差异表说的是形态,这一列说的是来源:同一条“金额不符”,从流水边报出来和从分录边报出来,处理方式完全不同,前者大概率是单位或者优惠,后者大概率是分账规则用错了版本。
有了它,你能按月回答“这个月的问题集中在哪条等式上”,也能在只跑通一条等式的时候说清自己还没对到哪一层。biz_key 给那些没有单号可挂的差异留了空串而不是 NULL,理由和上面 sub_mch_id 那条一样。TOTAL 这类用约定子键区分——TOTAL_CNT、TOTAL_AMT、MISS_MCH:子商户号,不然同一个批次里三笔 TOTAL 挤在同一个空串上,uk_diff 只留得下一行。
TOTAL 这一类抓的是整类缺失:汇总行声明的笔数、金额和你解析匹配出来的合计不一致,少了一个子商户、少读了一种 flow_type,单笔匹配永远发现不了。
BOOK_UNBALANCED 直接是 07 那条不等式在差异表里的名字,凭证不平就进这张表,跟渠道没关系,所以它不该等账单来才被发现,每天单独跑一次。batch_id 是 NOT NULL,分录这条等式没有账单批次,就给它自己开一条 bill_type = 'book' 的批次行,这样重跑、状态、龄期统计全都挂在批次上,不用为它单开一套。
处置要不要自动,看的是这个动作会不会动到别人的钱。我方有、渠道也确认收了,只是你的入账链路漏了一步,这种可以自动补:走 05 那个 transit 入口和 06 那个 apply(),同一套幂等键,别写第二条路径。状态不符也一样,以渠道为准推进状态,账务侧红冲,理由和 06 说的一样。
分录不平不能自动。这类差异一旦允许自动“补平”,07 里那个运营手动转账的问题就换个名字回来了:钱对上了,账外动作也留下了。
渠道有、我方无这一类要加一道熔断。06 写的是走自动退款,那是按单笔说的;同一个商户号当天这类差异超过三笔就全部转人工。计数落在库里,批次表加一列 auto_fixed_cnt 按商户累加,内存计数重启即清零,半夜重启之后熔断等于没有;三这个数是初期拍的,观察一个月按差异分布再调,先把数写在这儿承认它是拍的。单笔自动退是补错,成批自动退是资损,而这两件事在日志里长得一模一样。
自动处置必须出凭证,voucher_id 那一列就是干这个的。原因是重跑:对账任务重跑一次,处置逻辑就会再触发一次,判重不能靠“这条差异已经处理过了”这种内存里的判断,要靠 07 那个 uk_biz。
handler 要落成人名,哪怕初期是运营自己填。这张表没有主人的时候,只会一个结果:它只增不减。最老那条 first_seen_at 挂了四十天,意味着这四十天里没人看过它,那么对出差异和对不出差异没有区别。
对账系统自己也要被对一次
对账系统负责报差异,可它自己不报的时候没人管它。下面这几种失败跑出来的样子都是任务成功、日志干净,上线前值得逐条对着代码走一遍。
- 解析出 0 行,任务返回成功,第二天没人看。前面说的
total_cnt和parsed_cnt是它的解药。 - 同一天跑两次,第二次的空文件把第一次的结果覆盖。判据是
file_hash,哈希没变就别重跑解析,更别重跑处置。 - 匹配键写宽了,金额相同即配对,两笔同额单互相抵消,差异表干净得可疑。这类错误不报错,它只让后面的每一天都“对得上”。
- 按商户循环,catch 写在循环体外面。二十家跑到第七家抛异常,剩下十三家没对,任务状态是 DONE(完成)。改成循环体里 catch、每家一条批次记录,失败了只有那一家 FAILED。
- 重跑时旧差异还挂着。原始账单行按
uk_flow幂等,不动它;匹配标记和差异行是衍生数据,按batch_id先清再重算。清错了的代价是丢人工处理记录,所以handle_status为 INQUIRING 和 CLOSED 的行不能删,要结转。 - 报警接了但没人认领,指向一个已经离职的人的 webhook,和没接一样。
再往下就是那条能挂 CI 的检查:造出已知的不平,看它能不能被报出来。
@Test
void knownBreaks_shouldAllShowUpAsDiff() {
    seedOrderPaidButNoNotify();       // OUR_MISSING
    seedNotifyButNoOrder();           // CHANNEL_MISSING
    seedAmountOffByOneCent();         // AMOUNT
    seedRefundAcceptedAsSuccess();    // STATE
    seedFeeNotBooked();               // BOOK_UNBALANCED
    seedOneMerchantSkipped();         // TOTAL
    reconService.runBill(billDateOf("2026-12-09"));
    bookCheck.run(billDateOf("2026-12-09"));      // 分录那条等式不等账单
    assertThat(diffRepo.openCount()).isEqualTo(6);
    assertThat(diffRepo.types()).containsExactlyInAnyOrder(
        "OUR_MISSING", "CHANNEL_MISSING", "AMOUNT", "STATE", "BOOK_UNBALANCED", "TOTAL");
}
六个种子各砸一个洞,跑完差异表应该是六行、类型互不重复。这个测试第一次跑一般不会全过,缺口里露出来的是你对“什么算一条差异”还没定义清楚,而那个定义才是这套系统真正的规格。
TIMING 那类不进断言。它第一天看起来和 OUR_MISSING 一模一样,要到 T+3 那一轮才分得开,所以补单动作也不能挂在第一轮的匹配结果上:你补进去的那笔,可能只是渠道还没归集。
每天看的是这几个数:解析行数与汇总行的偏差、第一回合的匹配率、未关闭差异数、最老那条差异挂了多少天。偏差和匹配率管的是代码有没有在干活,差异数和龄期管的是有没有人在干活。
第一周只报不办
接这套东西的时候,把自动处置那一档关掉,只写差异、不做动作,跑一周再说。一周之后看那张表:有没有同一个 biz_key 每天重复出现,那是上游还没修;有没有哪一类 diff_type 一直是零,那多半是你那条等式根本没跑通。
系列:上一篇 分账的账要能倒推回去 | 下一篇 私有化部署的最小交付包,拔掉网线还能装起来才算 | 相关 数据迁移完了,没人敢关旧系统