死信队列要不要人工介入
两个场景,方向相反:一个系统的死信队列(消息重试耗尽后转入的队列)堆了 3000 条消息,三天没人发现,客户问「积分怎么没到账」才知道;另一个系统的值班同学凌晨两点被死信告警叫醒,爬起来对着 broker 控制台手动导出、重发,天亮一看重投的全是时段性网络抖动,重试机制本来就能消化。
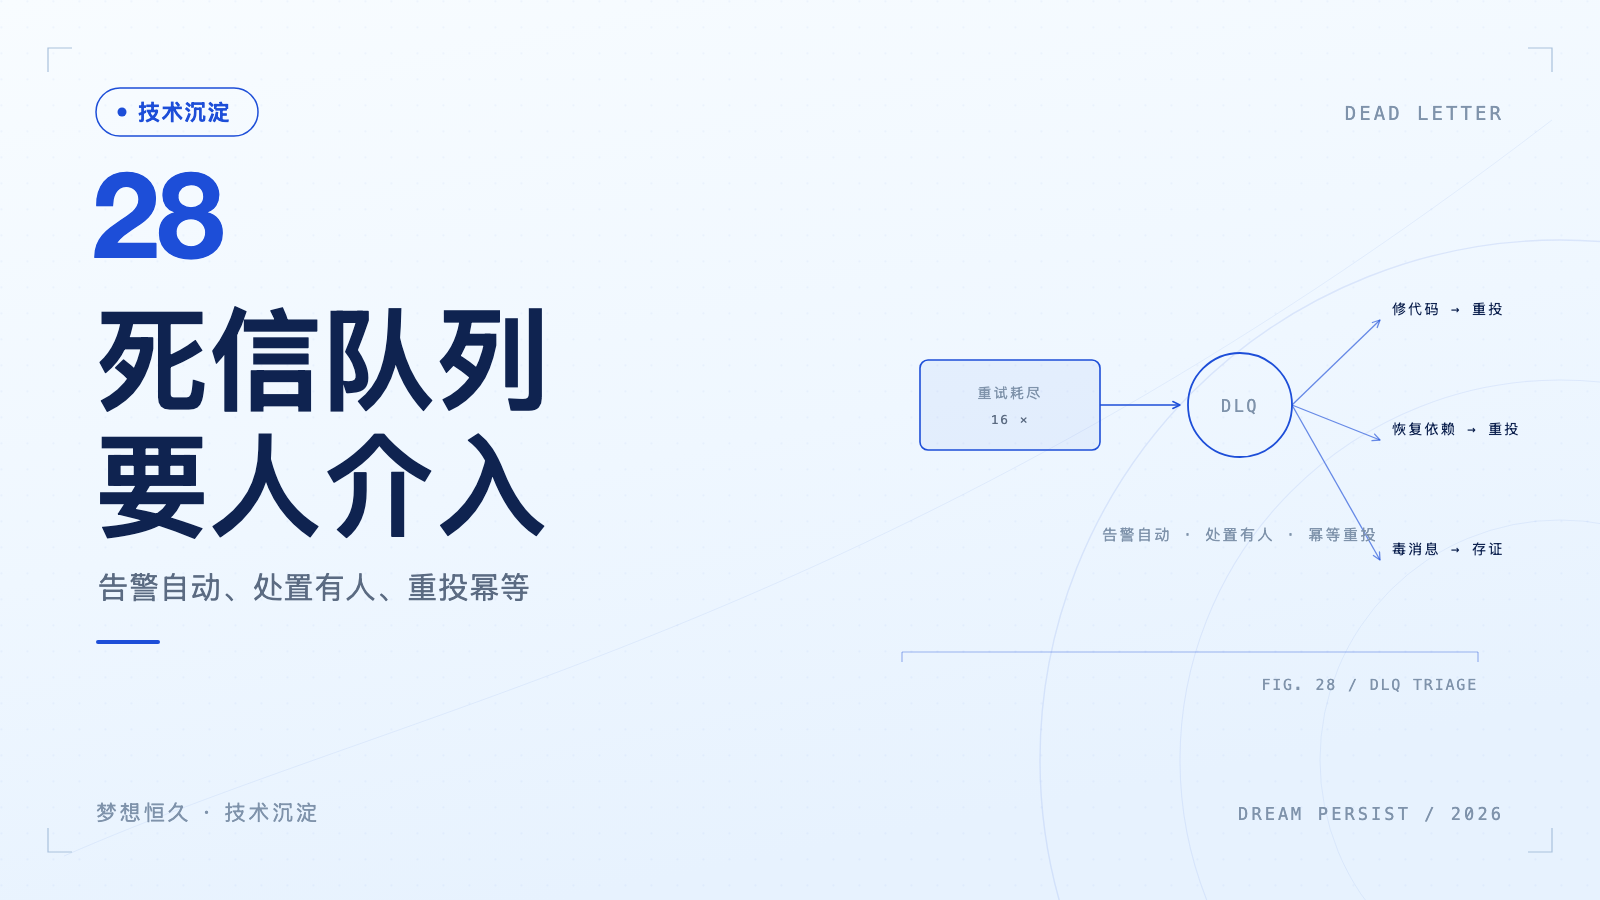
结论一句话:死信队列的价值在「把消费不了的消息圈出来等人裁决」,介入本身必须有人——但不是实时盯,而是每批死信在时限内有人分类处置;既不能指望全自动重投,也不能圈出来就没人管。
按成因分三类,处置动作完全不同:
| 成因 | 典型例子 | 处置 |
|---|---|---|
| 代码缺陷 | 字段解析失败、空指针 | 修代码发版,再批量重投 |
| 长时间依赖故障 | 数据库半小时不可用,超出重试窗口 | 先恢复依赖,确认恢复后批量重投 |
| 毒消息 | 数据本身残缺,永远消费失败 | 不重投,落库存证,走数据修正 |
RocketMQ 默认重试 16 次、间隔逐级拉长到小时级,这套设计已经把短时抖动挡在了死信之外——能进死信的,多数是后两类,处置前先分类,不分类全部重投只会把毒消息再毒一遍。
三条注意:
- 告警留痕:告警只报「有死信进来了」;处置走管理页的批量操作并留操作记录——翻 broker 控制台手动导出再重发,既容易选错队列,也不会留下痕迹。
- 先修后投:重投发生在修复之后,而重投的消息会重新走一遍消费逻辑,消费者本来就该有的幂等(同一笔只执行一次的防重设计,见重复消费那一篇)在这里是最后一道闸。
- 落表存证:毒消息的存证别只存在死信队列里,它有保留期限,落一张表记下原始报文和失败原因,数据修正有据可查。
系列:深文 延迟任务:超时关单、定时提醒的三种实现 | 相关 什么时候真的需要消息队列 | 技术纵深系列索引