权限系统:RBAC 不够用的地方,数据权限怎么补
“销售只能看自己的客户,主管能看整个部门的,成本价别让销售看到。”
这类话在需求会上出现过很多次,短到没人觉得需要评审。可它一句里塞了四个判定:哪些行算“自己的”,哪些列能给谁看,判定要在哪几个入口生效,以及“主管”这个身份什么时候作废。这四个 RBAC 一个都答不了。它答的是另一个问题——这个角色能不能点这个按钮。那个问题多数系统已经做对了,所以看起来一切正常。上一篇讲隔离模型时留了一句“跨租户权限模型得单独设计”,这一篇补的就是它。
一句需求里的四个判定
“哪些行”和“哪些列”是有没有做的问题,演示的时候看得见:换个账号登录,列表少了一半,成本价那列没了,客户点头。
“在哪几个入口生效”和“身份什么时候作废”是会不会漏的问题,演示看不出来。列表页裁掉了,导出没裁;角色当天改了,缓存里还是旧范围,客户第二天才发现某个销售还能看到别人的单子。后两个判定要真去点、去换、去导一次才知道。
我见过的大部分权限设计死在后两条上,不是因为想得浅,是因为前两条能交付、后两条不交付也没人当场问。
RBAC 里没有“哪一行”这个维度
权限这个词在中小系统里装了三件事,分开看很多设计就不用吵。
| 层 | 回答的问题 | 判定的时机 | 典型实现 | 漏了会怎样 |
|---|---|---|---|---|
| 功能权限 | 这个按钮、这个接口能不能碰 | 请求进来时 | RBAC,角色绑菜单和权限码 | 越权调用,干了自己不该干的事 |
| 数据权限 | 同一张表里,你能看哪几行 | 生成 SQL 时 | 数据范围条件拼进 where | 列表查全库,详情按 id 乱取 |
| 字段权限 | 同一行里,你能看哪几列 | 出参序列化时 | 查询不 select,或者序列化裁剪 | 成本价、手机号给不该看的人看到 |
RBAC 的判定函数抽象出来是 can(user, permission),入参里没有资源实例。它能回答“这个角色的菜单里有没有‘客户导出’”,回答不了“这次导出包含哪些行”。“哪一行”这个维度压根不在它的模型里,所以只能外挂。
外挂的东西有个共同毛病:配置次数不一样。功能权限是一次配置、全局生效,权限码绑在接口注解上,加一个接口配一次,漏了别人一眼能看见。数据范围是每个查询各配一次,配置次数大致等于接口数乘表数,再乘上列表、详情、count、导出、批量这几个变体。一个一百张表、三百个接口的系统,把这五个变体乘进去,是十五万处配置;任何一处配漏,都是一条越权查询的口子。这是它必然漏的算术原因,跟认不认真没关系。
把三层排到一次请求上,是这么一条链:用户是谁(认证)→ 属于哪个租户(上一篇的事)→ 能不能调这个方法(功能权限)→ 这次能看哪些行(数据权限)→ 这些行里能给你看哪几列(字段权限)。前三道在框架里有现成轮子,后两道基本要自己写,所以事故集中在后面。
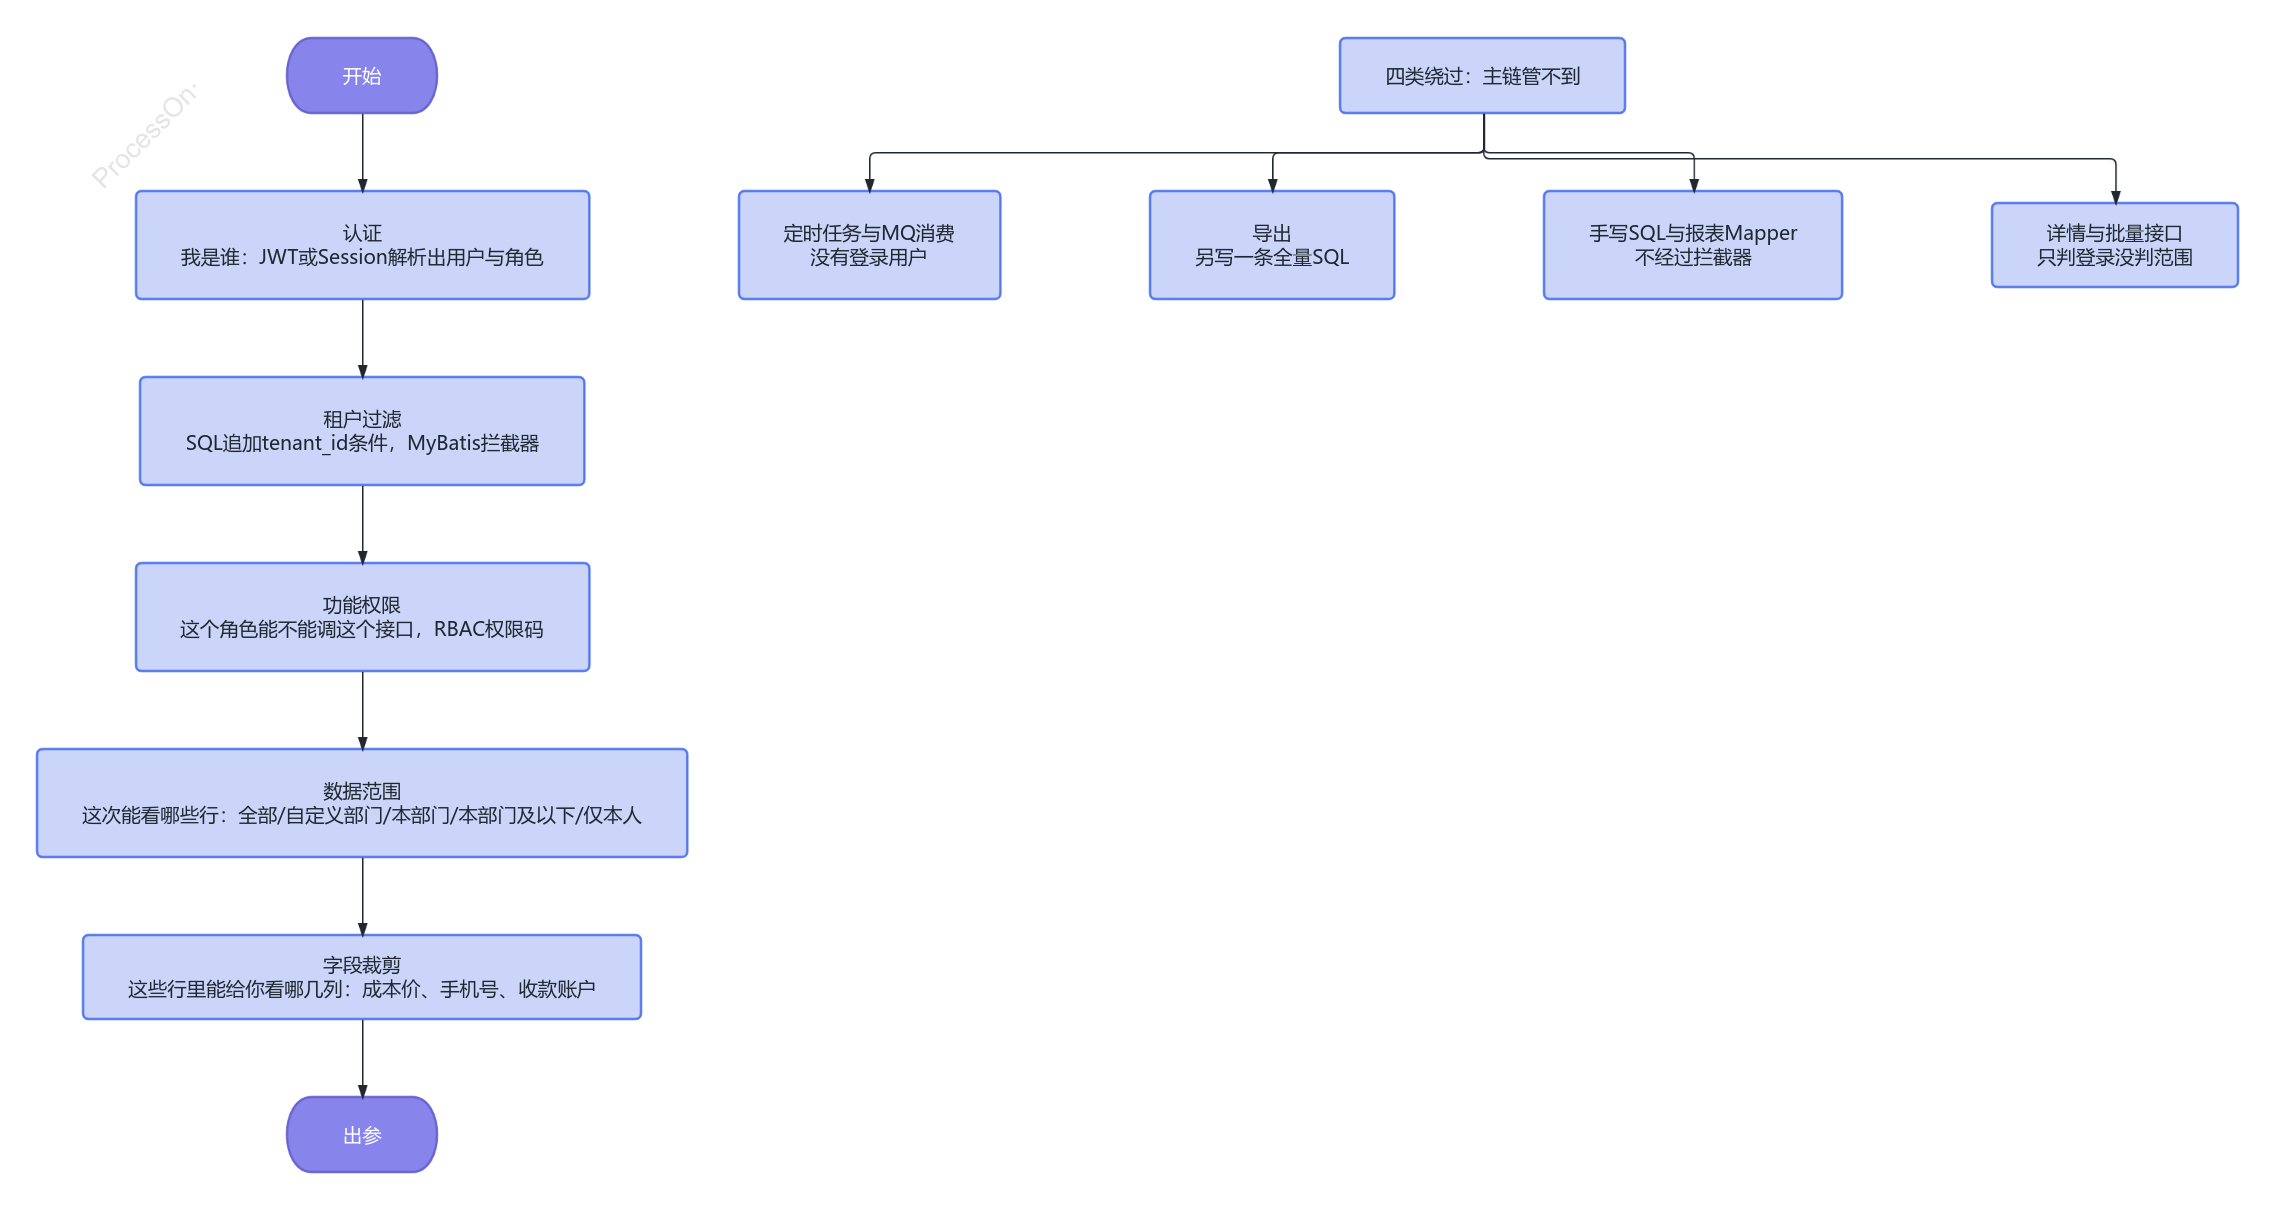
图 1:主链上的闸口,和右边四类不走主链的入口。右边那四类才是事故现场。
“本部门及以下”怎么变成一条 SQL
行级权限落地,绕不开“这个用户能看到哪些部门、哪些人的数据”。我见过的需求最后都能归到五种范围,跟 RuoYi 那套枚举几乎一一对应:全部数据、自定义部门、本部门、本部门及以下、仅本人。
第五种之外我还真没见过别的。有人加过“本部门及以上”、“我参与的客户”、“按业务线”,前一种是把树的方向写反了,后两种不是数据范围,是业务关系,应该建关联表,不该塞进枚举。范围枚举一旦长到七八种,角色配置页面就没人看得懂了。
CREATE TABLE sys_role (
  id          BIGINT NOT NULL PRIMARY KEY,
  tenant_id   BIGINT NOT NULL,
  role_key    VARCHAR(64)  NOT NULL,
  data_scope  TINYINT      NOT NULL DEFAULT 5,  -- 1全部 2自定义 3本部门 4本部门及以下 5仅本人
  UNIQUE KEY uk_tenant_role (tenant_id, role_key)
);

CREATE TABLE sys_role_dept (
  tenant_id BIGINT NOT NULL,
  role_id   BIGINT NOT NULL,
  dept_id   BIGINT NOT NULL,
  PRIMARY KEY (tenant_id, role_id, dept_id)
);
data_scope 用 TINYINT 不用字符串,这个字段每次请求都要判一遍,别存英文枚举名再在 Java 里 switch 字符串。两张表都带 tenant_id:角色名在租户内唯一,不是全局唯一;sys_role_dept 的主键从租户开头,跟第一篇那条键规则一致。
默认值那行值得多说一句:DEFAULT 5,不是 DEFAULT 1。新建一个角色、忘了配范围,系统应该给这个人最小的范围,而不是最大的。写成 DEFAULT 1 的话,忘记配置这个动作等于授权全部数据,而且它不报错,只会安静地多给。权限代码里的默认分支必须是拒绝,这条原则在后面拼条件那段还会再出现一次。
“本部门及以下”要有树。三种做法,取舍点不一样。
一种是冗余祖级列表,部门表加一列 ancestors,存这一行往上到根的那条链。某个部门的 ancestors 是 0,100,101,意思是它上面依次是根、100、101;要拿 101 下面的所有部门,就找祖先链里含 101 的那些行。RuoYi 就是这么做的,读多写少、不用递归。
写成条件是 dept_id = 101 or find_in_set(101, ancestors),前半句别漏:ancestors 里存的是别人,101 自己那一行不含 101,少了它「本部门及以下」就只剩「以下」。
坏处是 FIND_IN_SET 和左模糊都不走索引,LIKE '%,101,%' 一定全表扫;部门表几百行时无所谓,如果这个写法被复制去查客户归属、区域层级,几百万行就当场出事。祖级列表还要求移动部门时把整棵子树的 ancestors 一起更新,漏更新就会出现树看着对、查出来少几个节点。
另一种是 MySQL 8 的递归 CTE:
WITH RECURSIVE dept_tree AS (
  SELECT id FROM sys_dept WHERE id = #{deptId}
  UNION ALL
  SELECT d.id FROM sys_dept d JOIN dept_tree t ON d.parent_id = t.id
)
SELECT id FROM dept_tree;
它靠 parent_id 索引,移动部门只改一行,语义也更好读。前提是 MySQL 8,5.7 不支持;递归深度要设上限,脏数据把父子关系连成环,会一路撞到 cte_max_recursion_depth 才报错。
第三种是路径编码:部门表存一列 path,形如 /0/100/101/,查子树用 path LIKE '/0/100/%'。这个写法的价值在于右模糊能走索引,LIKE 'abc%' 是 range scan,而祖级列表那种左模糊永远走不了。代价是 path 是派生字段,移动子树要批量改写,而且列宽要按最大层级预留,VARCHAR(255) 在层级深的组织里真会撞墙。
我现在的选择标准:部门数几千以内、几乎不动,用 ancestors 加 FIND_IN_SET;层级会调整,或者同一个写法要复用到百万行的表上,用递归 CTE,把结果缓存在请求级上下文里,一次请求只解析一遍;查询子树是热点且量大,直接上 path 前缀匹配。不管哪种,都不要把部门 id 拼成 dept_id IN (…) 里一长串字面量,几百家部门能把 SQL 文本撑到几十 KB,解析成本和语句缓存命中率都很难看。
还有一个更靠前的问题:单据上的 dept_id 到底是什么。销售小张从华东组调到华南组,他上个月成交的那两单,归属部门跟着他走吗?
跟,历史业绩就改了归属,上个月的部门报表今天重跑对不上;不跟,就要承认这个字段是成交那一刻的快照。我的做法是 dept_id 存快照,员工调动不改历史单据,需要“我手上正在跟的”就按 owner_user_id 判,需要“我们部门历史成交的”就按快照 dept_id 判。两个字段语义不同,别互相推导,也别用触发器去同步——同步的那一刻,历史就不历史了。
最后是范围解析结果放在哪。多角色的时候取并集(能看全部的和只能看本人的同时存在,结果应该是全部),这件事要算一次,然后有个缓存位置的选择:
塞进 JWT:请求时零开销,但角色改了要等 token 过期才生效,而且部门多的时候那几百个 id 会把 token 撑大,网关和 nginx 的请求头上限一般是 8K 左右,超了直接 400,报的还是 HTTP 层的错,跟权限看起来没关系。
塞进 Session:体积问题没了,失效问题还在,得在角色保存和部门移动的地方主动清 Session。
每次请求查库:语义最干净,多两次查询(角色、部门子树),部门子树可以单独放本地缓存。
我选第三种加本地缓存,缓存 key 带一个版本号:sys_role 和 sys_dept 各维护一个 config_version,改角色、动部门就 bump,缓存 key 拼上它,旧条目自然作废。失效动作写在角色保存和部门移动这两个入口,不指望 TTL。靠 TTL 的话,客户会在那个窗口里看到他不该看的东西,而权限事故的定性不看窗口多短。
条件拼在哪一层,就漏在哪一层
数据权限最后都会变成一个 where 片段。放哪一层,决定了它会在哪些入口失效。
最流行的是注解加 AOP,RuoYi 的 @DataScope(deptAlias = "d", userAlias = "u") 就是这个套路:切面算出过滤条件,塞进 params.dataScope,Mapper XML 里 ${params.dataScope} 拼上去。它省事,所有查询一行注解搞定。它的三个问题也都来自省事。
第一,${} 是字符串拼接,不是 #{} 占位。只要拼进去的内容有来自请求参数的部分,就是 SQL 注入点。这类拼法在开源框架里被公开利用过,不是理论风险。真要这么写,过滤条件里的每个值都必须是服务端自己算出来的数字或枚举,前端传来的部门 id 要先查库验证归属,再落进 SQL。
第二,它只覆盖被注解的方法。手写 SQL、@SelectProvider、JPA 的 @Query、报表接口、从别的项目复制过来的 Mapper,全部绕过。判断标准很土:把这条 SQL 打到日志里看有没有那个条件,别看代码里有没有注解。
第三,它依赖“当前登录用户”这个上下文。定时任务、MQ 消费、异步线程池里没有登录用户,切面要么拿到 null 直接放过,要么抛异常。前一种更危险,查全量还看不出来。这跟上一篇的租户上下文是同一个病根,那篇漏的是 tenant_id,这篇漏的是 dept_id。
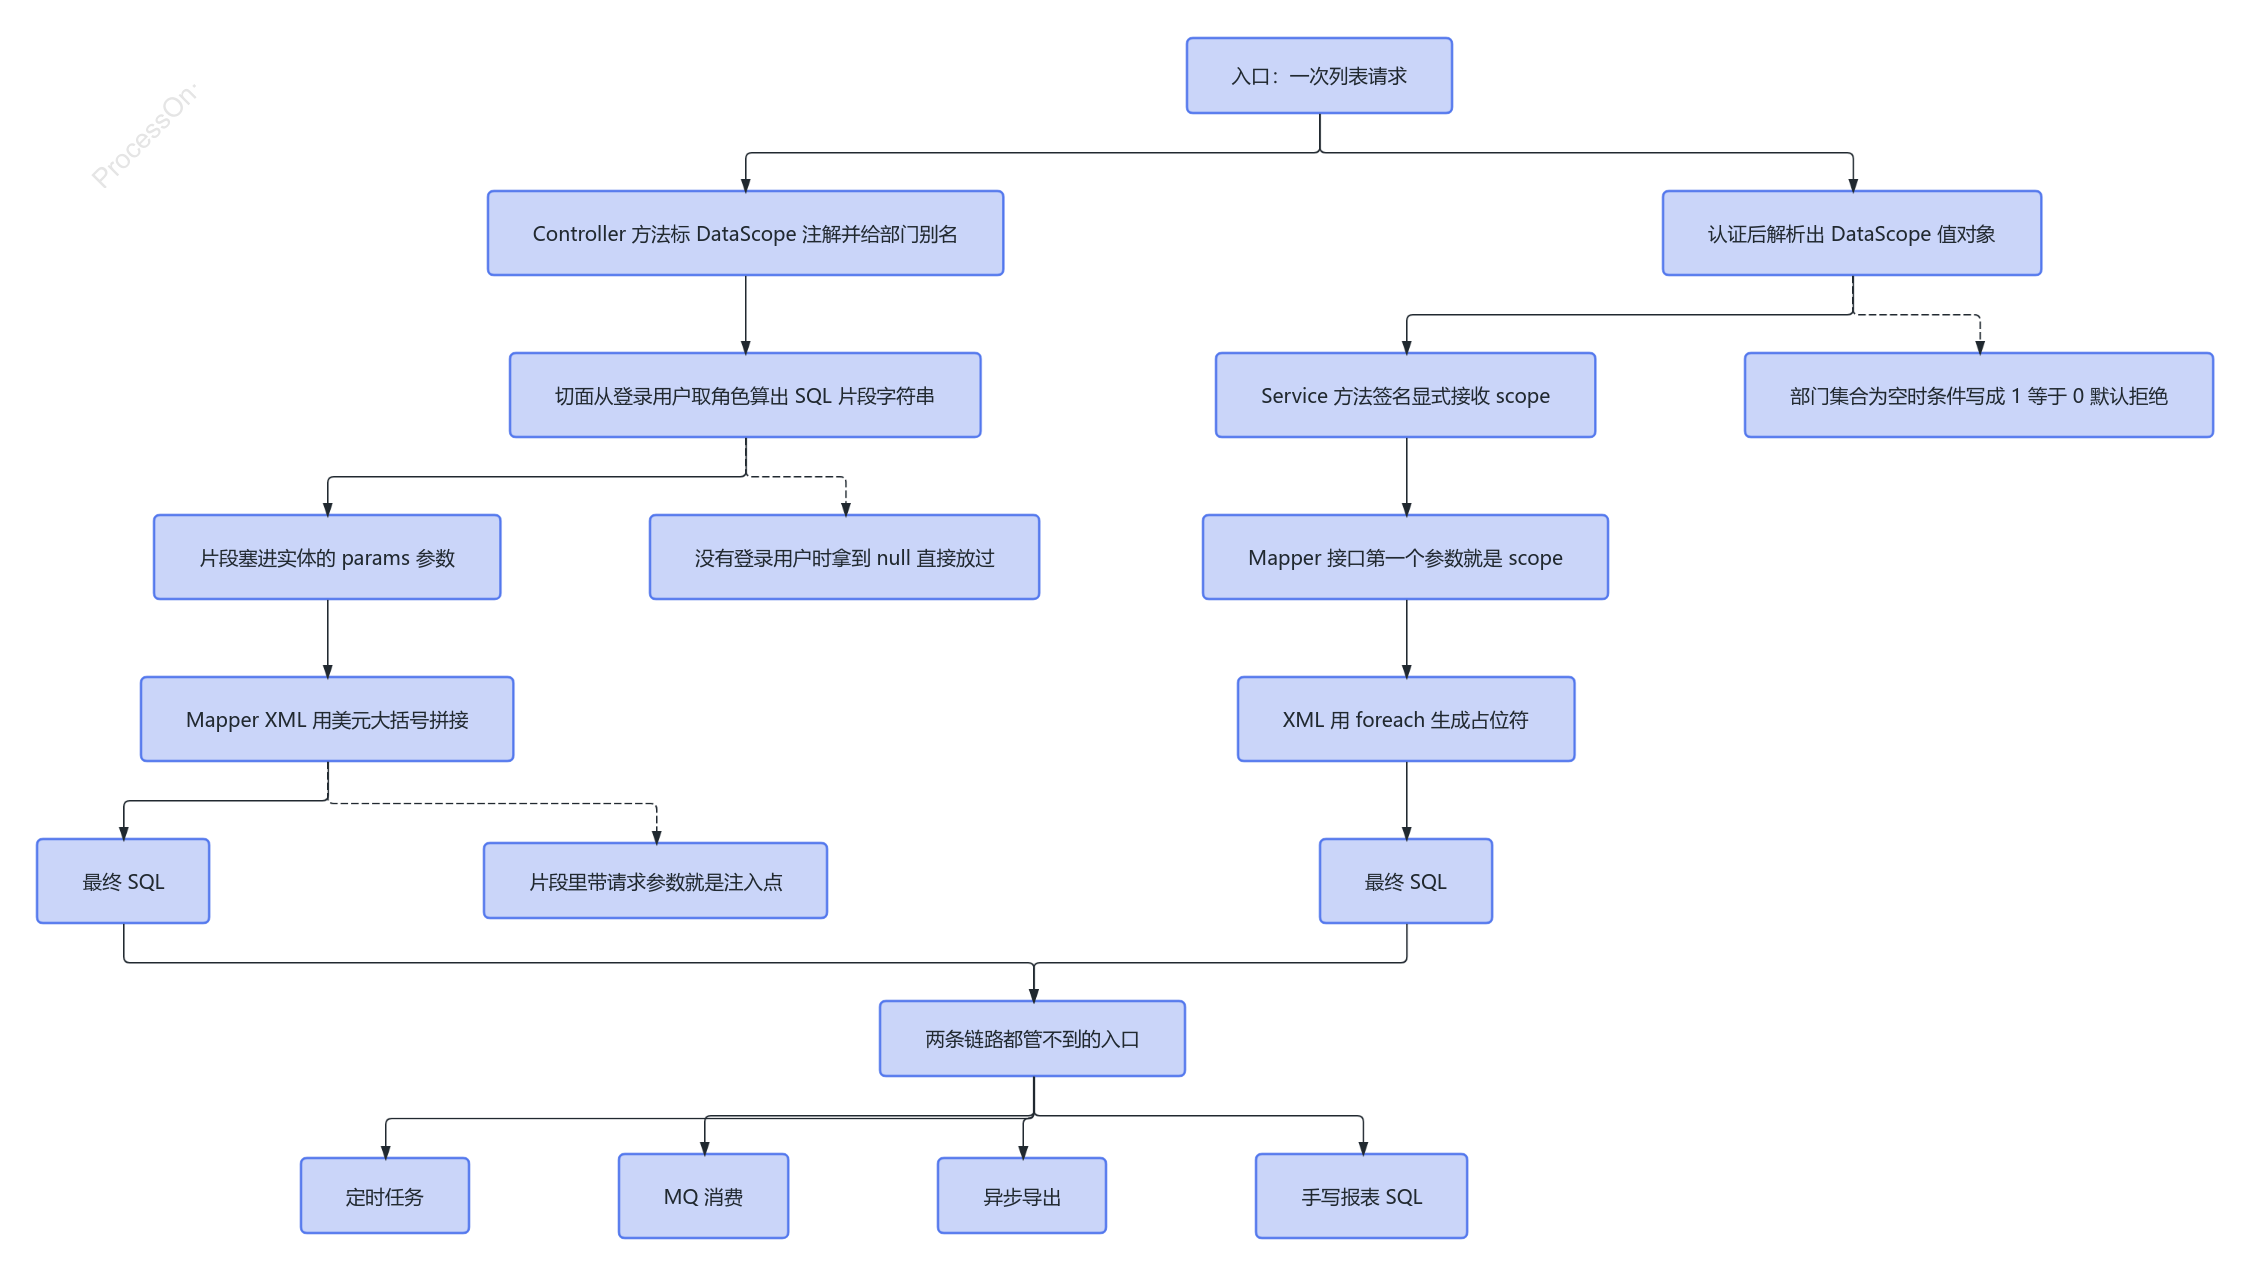
图 2:两条拼接链路。左边靠切面算字符串,右边靠值对象显式传参;虚线标的是各自的失效点,最下面那四个入口两条链路都管不到。
更稳的做法是把范围解析成一个值对象,在 Service 层显式传给 Mapper。
public record DataScope(boolean all, Set<Long> deptIds, Long userId) {

    public static DataScope of(LoginUser user) {
        List<Integer> scopes = user.getRoles().stream()
                .map(SysRole::getDataScope).toList();
        if (scopes.contains(1)) {
            return new DataScope(true, Set.of(), null);
        }
        Set<Long> depts = new HashSet<>();
        List<Long> customRoleIds = user.getRoles().stream()
                .filter(r -> r.getDataScope() == 2)
                .map(SysRole::getId).toList();
        if (!customRoleIds.isEmpty()) {
            depts.addAll(roleDeptMapper.deptIdsByRoleIds(customRoleIds));
        }
        for (Integer scope : scopes) {
            if (scope == 3) {
                depts.add(user.getDeptId());
            } else if (scope == 4) {
                depts.addAll(deptMapper.descendantsOf(user.getDeptId()));
            }
        }
        Long onlySelf = scopes.contains(5) ? user.getUserId() : null;
        return new DataScope(false, depts, onlySelf);
    }
}
onlySelf 不能写成 scopes.contains(5) && depts.isEmpty()。一个人同时有“本部门”和“仅本人”两个角色时,部门集合非空,按那个写法 onlySelf 会被置空,他自己历史成交、但已经调出当前部门的单就看不见了。角色是并集,不是优先级。同理,sys_role_dept 的键是角色,不是用户;查自定义部门要先拿角色 id,别把一个 userId 传进按角色建的关联表。
Mapper 里用 <if> 拼条件,deptIds 走 <foreach>,不拼字符串:
<if test="scope.all == false">
  and (
    1 = 0
    <if test="scope.deptIds.size() > 0">
      or o.dept_id in
      <foreach collection="scope.deptIds" item="d" open="(" separator="," close=")">#{d}</foreach>
    </if>
    <if test="scope.userId != null">
      or o.owner_user_id = #{scope.userId}
    </if>
  )
</if>
那个 1 = 0 是故意的:范围解析出来是空集时,结果应该是查不到,而不是条件不成立、整段被跳过、于是查全量。跟 DEFAULT 5 同一个原则。
值对象这条路也有它自己的漏法,而且不太直观。
条件挂在哪个表上。@DataScope(deptAlias = "d") 这种写法,条件挂在 join 出来的部门表 d 上,一旦业务表是 left join sys_dept d,where d.dept_id in (…) 会把左连接变成内连接的效果:客户没填归属部门、或者归属的部门被删了,这一行整个消失。表现是销售说“我的客户少了一个”,查数据权限查半天,其实是 join 语义被条件改了。条件应该挂在业务表自己的 o.dept_id 上,哪怕它是个冗余字段。
count 和列表是不是同一条 SQL。分页插件会生成 count 语句,如果项目里给某些查询手写了 selectCountXxx,范围条件只加在列表那条上,就会出现总数和实际行数对不上。前端显示“共 1200 条”,翻出来只有 30 条,客户报的 bug 单上写的是“分页坏了”。
插件顺序。租户改写、数据权限这类改 where 的插件,要放在分页插件之前,让 count 也被改写。反过来的话分页插件先按原始 SQL 算总数,再被后面的插件改写成带条件的 SQL 查列表,必然对不上。
索引要跟着改。加了 dept_id 条件之后,原来为 create_time 建的索引未必还最优。where tenant_id = ? and dept_id in (…) order by create_time desc limit 20 这种查询,索引顺序一般是 (tenant_id, dept_id, create_time),而 IN 之后的列再排序,MySQL 会用 filesort。数据量大了要单独看执行计划,别指望索引名字里字段齐了就万事大吉。
最后是显式传参的代价:多一个参数,别人新增方法时会忘记传。我的兜底是再写一个很薄的 MyBatis 拦截器,凡是命中“需要范围”的 Mapper 命名空间,参数里找不到 scope 就抛异常,让它在启动自检或者第一次调用时就炸,而不是安静地查全量。
用 MyBatis-Plus 的话有 DataPermissionInterceptor 和 DataPermissionHandler,思路跟上一篇的 TenantLineInnerInterceptor 一样,在 SQL 上追加条件,不用改 Mapper。它解决的是“漏加”,不解决“绕过”:不经过 MyBatis 的查询、以及被 @InterceptorIgnore 关掉的语句,照样漏。
成本价是怎么整整齐齐出现在 Excel 里的
同一张报价单,销售看得到成本价,客服看不到;财务看得到收款账户,销售看不到。这就是字段权限。
三种实现,失效方式各不一样。
查询时不 select:select 列表按权限动态生成,不给的列压根不出库。最省,代价是 SQL 模板变复杂,缓存和 ORM 映射要多测一层。它防不住的是有人后来改了那条 SQL,把列加回去。
出参序列化时裁剪:实体不变,用 Jackson 的 @JsonView 或者自定义序列化器按权限过滤字段。改动最小,适合列不多的场景。它的成立条件是所有出参都走同一个序列化配置,Controller 不能直接返回实体。
展示层脱敏:手机号中间四位打星,身份证只留首尾。这是脱敏,数据还是查出来了,只是在最后一步糊上,日志、缓存、接口调试工具里都是原值。该脱敏的要脱敏,但别把它当字段权限。
三种都能做对,问题在第四个入口。列表接口裁剪了,详情接口没裁;详情接口没裁是因为它是后来补的,图省事直接返回了实体。这类漏法在四个入口上反复出现,四个入口共用同一份实体,只有一个做了裁剪。
列表那条最容易看错:裁剪做了,但 count 语句还是查了全字段,多耗一点无所谓,怕的是有人把 count 那条改成 select * 复用。下拉选项和统计接口是另一个,接口只返回 id 和名称,看着很安全,如果名称字段本身就是敏感的(客户名称在某些行业就是商业信息),返回 id 加名称等于全给。
字段权限再往前一步是配置化:字段元数据表加序列化裁剪,后台能配“这一列谁能看”。我没做,判断标准也很主观——看客户会不会真的自己去配。多数客户配了两次就不配了,然后回来找你,这时候你多出来的那套元数据表只增加了 bug 面积。
导出这条要单独说,因为它是上一篇那个事故的另一种复发形式,而且它必然漏。
导出要的是“全量”,而列表接口里分页条件和范围条件是绑在一起写的——同一个 QueryWrapper,或者同一段 XML。作者要绕过分页,最省事的路径就是另写一条 SQL,这一绕就把范围条件和字段裁剪同时绕掉了。结果就是:列表页看不见成本价,导出的 Excel 里成本价一列整整齐齐。
两条修法,选一条,别混。
让导出复用列表的查询条件:把范围解析和字段裁剪提成方法,列表和导出两边调同一段代码。前提是导出的数据量可控,能走分页游标分批写。
导出走异步任务:任务参数里带上发起人,任务里重新解析身份和范围。
public record ExportCommand(long submitterId, Set<String> columns, long submittedAt) {
}
这里有个细节容易做错:任务里应该用 submitterId 重新查一次用户、重新解析一遍 DataScope,而不是把提交那一刻的 scope 序列化进任务参数照用。排队三分钟和排三天,权限可能已经变了。如果业务上就是要“按提交那一刻的权限导出”,那也行,但要把这句话写进注释和验收标准,别让它成为一个隐式行为。
把地址栏里的 id 改一位数字
这一条是行级权限里最常见的错觉:列表接口加了范围条件,就以为详情也安全。
详情接口是 getById(id),只判了登录,没判这个 id 在不在当前用户的范围里。不用猜密码,把列表里的 id 换成连续数字就行。这类越权有个通用名字叫 IDOR,在权限事故里占比很高,原因就是前面那句算术:列表的过滤是一次加对,详情的过滤是每个接口都要加对。
详情类接口不接裸 id,接 id 加范围断言,Service 里查完再判一次。
public CustomerDetail load(long id, DataScope scope) {
    Customer customer = customerMapper.selectById(id);
    if (customer == null) {
        throw new NotFoundException();
    }
    boolean allowed = scope.all()
            || scope.deptIds().contains(customer.getDeptId())
            || (scope.userId() != null && scope.userId().equals(customer.getOwnerUserId()));
    if (!allowed) {
        throw new ForbiddenException();
    }
    return converter.toDetail(customer);
}
owner 匹配那半句有个隐蔽的坑:Objects.equals(scope.userId(), customer.getOwnerUserId()) 两边都可能是 null。没有「仅本人」角色的人 userId() 返回 null(DataScope 里 null 的含义就是这个人不靠 owner 匹配),客户表里没填归属的行 ownerUserId 也是 null,Objects.equals(null, null) 会返回 true——只有「本部门」范围的销售,能把全库没填归属的客户按 id 一条条拉出来。所以上面这行写成 scope.userId() != null && …,null 对 null 不算命中;列表 SQL 里那句 <if test="scope.userId != null"> 挡的是同一件事,两处防线要长一个样。
查不到和没权限在代码里分成两个异常,对外返回要一致。越权访问别人单据的时候回一句“该数据不属于你的部门”,等于告诉对方这个 id 存在,剩下的就是枚举。统一回 404,或者统一的“数据不存在或无权限”。
批量接口是详情接口的放大版。POST /customers/batch 传一个 id 数组,实现里如果是 selectBatchIds,范围条件完全没走。要么在 SQL 里带上范围,要么查完按范围过滤,并统计被过滤掉的条数:过滤数量大于 0 就记一条日志。这个日志很值钱,它会把“前端把不该显示的 id 传上来了”这类问题提前暴露出来,而不是等客户投诉。
判断这些有没有真生效,我不太信清单,清单靠人执行,人会跳过。我信两条能挂在 CI 上的东西。
第一条是那个换 id 的动作,写成参数化测试。
@ParameterizedTest
@ValueSource(strings = {
        "GET:/customers/4001",
        "PUT:/customers",
        "DELETE:/customers/4001",
        "POST:/customers/4001/audit",
        "POST:/customers/export"})
void outsiderCannotTouchOtherDeptsRow(String call) {
    // 4001 属于别的部门,当前登录用户是 A 部门的销售
    var response = rest.callAs("sales_dept_a", call);

    assertThat(response.status()).isIn(403, 404);
    assertThat(response.body()).doesNotContain("13800001111");
}
rest 换成你们项目里的测试客户端,MockMvc、RestTemplate 都行,重点是那两行断言:状态码要落在拒绝里,返回体里不能出现敏感字段的内容。只断言列表查不到的测试等于没测,因为列表恰好是最容易加对的那个。
第二条是接口差集,它回答“还有多少接口是裸的”。
RequestMappingHandlerMapping mapping =
        context.getBean(RequestMappingHandlerMapping.class);
mapping.getHandlerMethods().forEach((info, method) -> {
    boolean guarded = method.hasMethodAnnotation(PreAuthorize.class)
            || method.getMethodAnnotation(RequiresPermission.class) != null;
    if (!guarded) {
        log.warn("no permission annotation: {}", info);
    }
});
启动时跑一遍,把没有权限注解的方法打出来。误报很多:登录、字典、健康检查、内部回调、开放接口,所以要配一份白名单,看的是差集而不是全量。差集里剩下的就是“谁登录都能调”的接口,通常里面会躺着几个统计接口和一个内部运维接口。这段代码别留在生产常开,另外 /actuator/mappings 本身就是一份完整接口清单,生产环境不要暴露出去。
不讲认证和审计,也不把字段权限做成配置
认证、审计、工作流里的审批人计算都不在这一篇;字段权限只做到查询不 select、出参裁剪和展示层脱敏这三档,配置化那套没做,多数客户也配不起来。
代码是骨架,不是能直接复制上线的实现;DataScope 的取数方式要按你的组织模型重画,文中那几条 MySQL 行为判断用真实表结构 EXPLAIN 一遍再决定。改多少东西,取决于范围条件现在拼在第几层:Mapper 里是一条 SQL,切面里要补导出、详情和批量,收成值对象才是改一处、往下传。先看清它站在哪一层,再决定动哪里。
系列:上一篇 多租户不是加一个 tenant_id:三种隔离模型与选型 | 下一篇 部门、门店、代理商,一张 sys_dept 表撑不住这三层 | 相关 RAG 知识库实战:检索不准,问题多半不在大模型