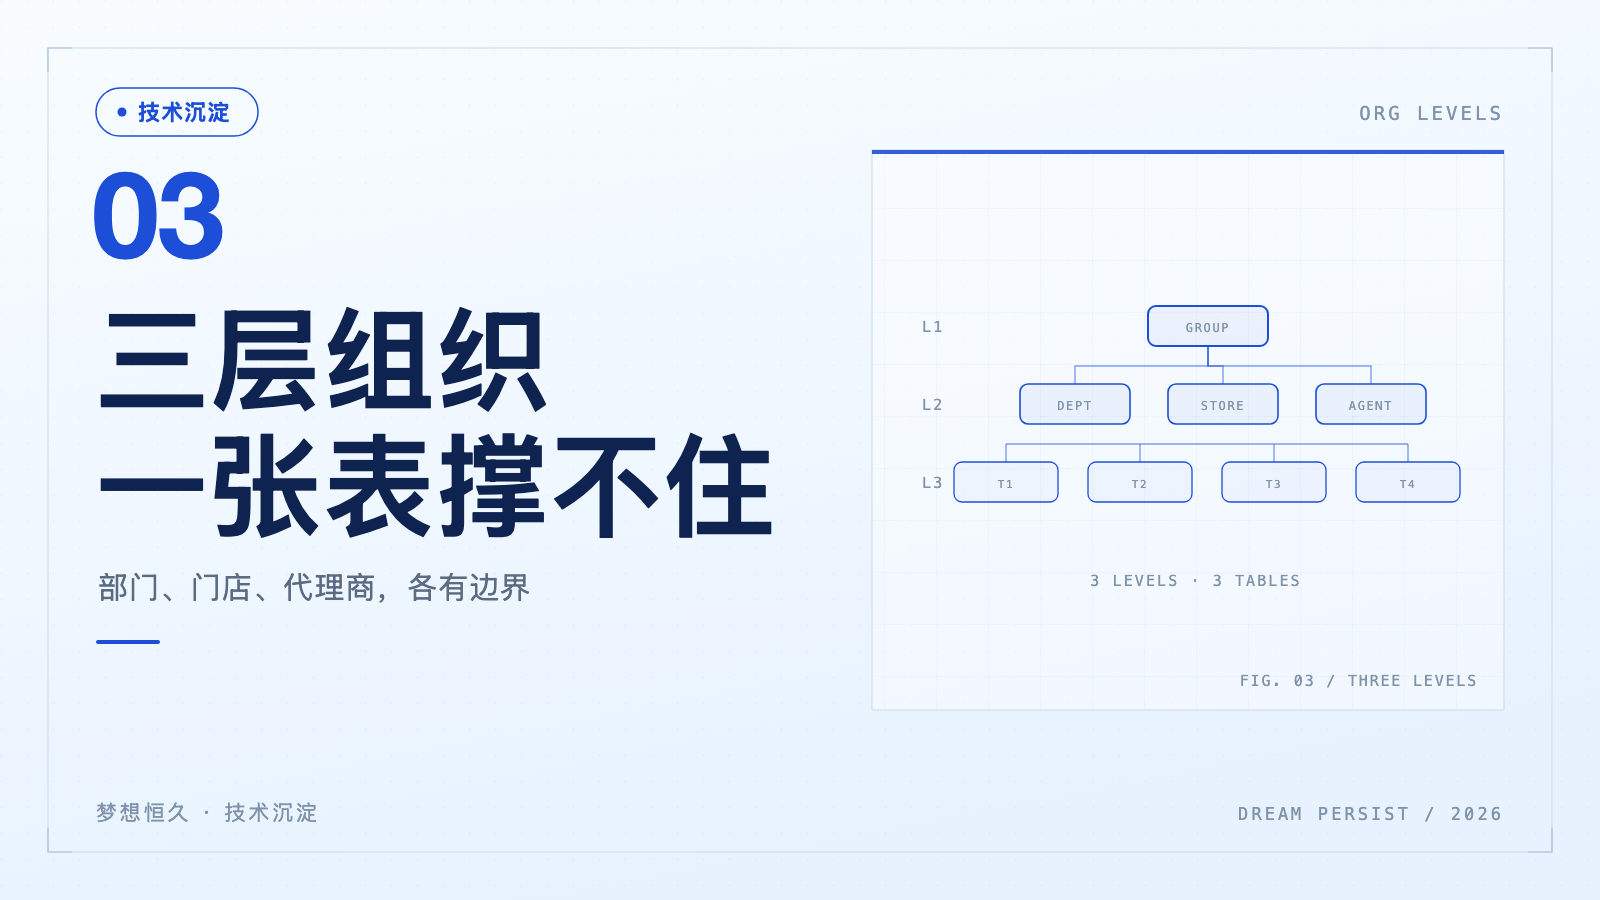
部门、门店、代理商,一张 sys_dept 表撑不住这三层
需求是“要加门店”。多数团队的第一反应差不多:看一眼 sys_dept,有 parent_id、有 name、有现成的树组件,那就加一列 type,1 是部门、2 是门店。两行代码,当天上线,测试也没提什么。
后面陆续会撞上几件事。加代理商,type 多了个值 3。再然后,运营和核算要两套口径。最晚上门的一件是财务:返佣改成按代理商结,他拿着两个月的对账单来问为什么差了一笔,而中间只做过一次区域合并。
type 这一列是个信号。它加进 sys_dept 的那一天,三层就被压成一层了。
type 加下去之后会发生什么
先冒出来的是 where type = 2。每个查门店的接口都得带上它,一开始是两三个,半年后是几十处,漏一处就把门店当部门统计进了组织报表。这类 bug 的复现路径特别朴素:新人复制了一段 SQL,没带 type。
接着是需求变了,运营口径和财务口径要分开:门店日常运营归区域管,核算归总部。type = 2 的行开始需要两个归属,而 parent_id 只有一个。到这一步有人会顺手把 parent_id 扩成两列,那是另一个坑,这篇不展开。
关联表跟着复制。user_dept 管员工和部门,现在要管员工和门店,于是加 user_store;再来代理商,加 user_channel。三张结构一模一样的表,三套一模一样的增删改接口。上一篇那个 DataScope 值对象里只有一个 deptIds 集合,到这里变成三个。这条排不上最疼,它只是烦——写第四套 CRUD 的时候骂两句就过去了。
属性稀疏是同一件事的另一面。门店有地址、营业时间、库存上限,代理商有合同号、结算周期、返佣规则,部门就一个名字和一个负责人。挤在一张表里,就是几列永远只有一类行有值,另外两类全是 NULL。想省列就上 JSON 扩展字段,然后所有查询开始 json_extract。
外键建不了这件事安静一些。parent_id 指向的到底是部门还是门店,数据库层面不知道,全靠代码判断。代理商下面挂一个部门、门店下面挂一个代理商,没有约束会拦;这种数据一旦出现,递归 CTE 算出什么都有可能。
上面这些都会有人提 bug。开头财务那次不会,他只说一句“这个数不对”。区域合并过一次,挂在部门树上的代理商跟着换了爹,返佣归属就跟着变了——会算钱的主体和被算钱的主体是同一个 id,这个坏的不是数据,是账。
三棵树不是一棵树
真正的差别不在层级深浅,在三件事:谁需要历史,谁会算钱,谁是外部人。
| 维度 | 行政组织 | 经营单元 | 外部主体 |
|---|---|---|---|
| 回答的问题 | 谁汇报给谁 | 在哪儿做生意、货在谁手上 | 这单算谁的、钱付给谁 |
| 要不要历史 | 不要,人事只看当前状态 | 半要,门店会换区、换代理商 | 必须要,已经结过的不能重算 |
| 成员是谁 | 内部员工 | 内部员工,加外部店长 | 外部账号,不是自己人 |
| 调整一次的后果 | 以后谁能看到这些数据 | 以后谁履约、谁的库存 | 已付款项跟着变,资损 |
就是上面这几行的差别,决定了为什么是三张表。行政组织的调整语义是“从今天起”,经营归属的调整语义是“从某个日期起”,结算主体的调整语义是“已经结算的不动,从下一期起”。三个“起”字不一样,硬塞进一张表就得有一方妥协,而每次妥协的通常是钱那一方,因为财务发现的时候总是最晚的。
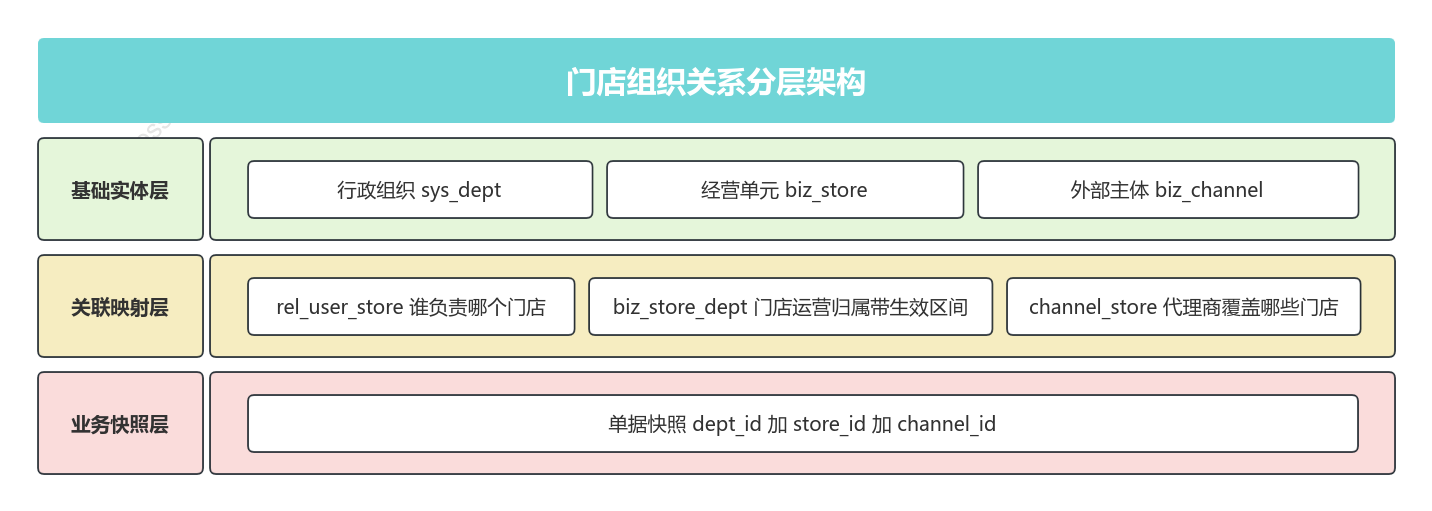
图 1:三个主数据各一棵树或一张表,靠三张关系表连起来,最后都落到单据的三个归属字段上。
分成三张主表,加三张关系表
sys_dept 只回答谁汇报给谁
CREATE TABLE sys_dept (
  id             BIGINT NOT NULL PRIMARY KEY,
  tenant_id      BIGINT NOT NULL,
  parent_id      BIGINT NOT NULL DEFAULT 0,
  dept_name      VARCHAR(64) NOT NULL,
  ancestors      VARCHAR(255) NOT NULL DEFAULT '0',
  leader_user_id BIGINT NULL,
  status         TINYINT NOT NULL DEFAULT 1,
  KEY idx_tenant_parent (tenant_id, parent_id)
);
没有 type,没有地址,没有合同号。它只服务两件事:人事的组织架构展示,和“本部门及以下”这种行政范围。树的做法沿用上一篇那三种(祖级列表、递归 CTE、路径编码),不重复。
biz_store 是经营单元
CREATE TABLE biz_store (
  id           BIGINT NOT NULL PRIMARY KEY,
  tenant_id    BIGINT NOT NULL,
  store_code   VARCHAR(32) NOT NULL,
  store_name   VARCHAR(64) NOT NULL,
  ops_dept_id  BIGINT NULL COMMENT '当前运营归属,只为列表页方便,历史不靠它',
  status       TINYINT NOT NULL DEFAULT 1,
  UNIQUE KEY uk_tenant_code (tenant_id, store_code),
  KEY idx_ops_dept (tenant_id, ops_dept_id)
);
门店不是树,是一个个独立个体,它挂到组织上靠关系表,不靠 parent_id。ops_dept_id 这一列是故意留的冗余,给“这个门店现在归哪个区”这种高频查询少一次 join。要清楚它是快照式的当前值,别拿它算历史。
biz_channel 是外部主体
三张主表里只有这张可以晚一点建。如果这个租户就是几十家直营门店、没有要按外部主体算钱这回事,先别建,部门加门店两张就够;等需求真来了再补,补的成本比空着低。
CREATE TABLE biz_channel (
  id                 BIGINT NOT NULL PRIMARY KEY,
  tenant_id          BIGINT NOT NULL,
  channel_name       VARCHAR(64) NOT NULL,
  contract_no        VARCHAR(64) NULL,
  settle_cycle       TINYINT NOT NULL DEFAULT 1 COMMENT '1月结 2季结',
  commission_rule_id BIGINT NULL,
  status             TINYINT NOT NULL DEFAULT 1
);
代理商有生命周期:签约、生效、终止、可能续签。这个生命周期跟部门树的“启用停用”不是一回事,部门停用不影响历史归属,代理商终止了还得把最后一期佣金结掉。这也是它必须独立成表的原因之一。
关系表要带时间区间
CREATE TABLE biz_store_dept (
  tenant_id     BIGINT NOT NULL,
  store_id      BIGINT NOT NULL,
  dept_id       BIGINT NOT NULL,
  relation_type TINYINT NOT NULL DEFAULT 1 COMMENT '1运营 2核算',
  valid_from    DATE NOT NULL,
  valid_to      DATE NOT NULL DEFAULT '9999-12-31',
  PRIMARY KEY (tenant_id, store_id, relation_type, valid_from),
  KEY idx_dept_period (tenant_id, dept_id, valid_to)
);
关系表也带 tenant_id,这是第一篇那条规矩的延续:每张表第一天就写进去,将来拆库、回溯、按租户清理都靠它。等要拆的时候再补,就得在一张几千万行的表上加列。主键也从 tenant_id 开头;store_id 现在是全局生成,单库不会撞,但关系表的主键是物理顺序,按租户拆库或归档时,没有租户那一列,数据就得整表重排。
“运营归区域、核算归总部”用 relation_type 区分,同一个门店在同一时刻有两条不同用途的归属,这才是一个门店两个部门的正确解法——不是把 parent_id 变成两个字段。
区间一律用左闭右开 [valid_from, valid_to)。写成半开不是为了好看:7 月 31 日如果既是旧归属的结束日又是新归属的开始日,按天聚合的报表在这一天就会双计或者漏计。查当前用 valid_to = '9999-12-31',查某天归属用 valid_from <= ? and valid_to > ?,一个等号一个严格小于,别写成两个闭区间。
为什么不是一张统一节点表。有人会想抽一个 org_node(id, node_type, parent_id, ext_json),一套树组件通吃三类。这个方案的省下来的是建表工作量,赔进去的是:属性要么散在 ext_json 里(json_extract 不走索引,得给虚拟列单独建索引,等于给一个本不该存在的妥协再打个补丁),要么外键关系彻底消失,parent_id 的合法性只能靠代码。它换来的那个“统一树”,业务上从来没有真实存在过——没人真的想在组织架构里看到代理商。
数据范围从一维变成三维
上一篇的 DataScope 只有一个部门集合,到这里要扩:
public record DataScope(
        boolean all,
        Set<Long> deptIds,
        Set<Long> storeIds,
        Long channelId,
        Long userId) {
}
条件也就从一段 IN 变成四段 OR:
<if test="scope.all == false">
  and (
    1 = 0
    <if test="scope.deptIds.size() > 0">
      or o.dept_id in
      <foreach collection="scope.deptIds" item="d" open="(" separator="," close=")">#{d}</foreach>
    </if>
    <if test="scope.storeIds.size() > 0">
      or o.store_id in
      <foreach collection="scope.storeIds" item="s" open="(" separator="," close=")">#{s}</foreach>
    </if>
    <if test="scope.channelId != null">
      or o.channel_id = #{scope.channelId}
    </if>
    <if test="scope.userId != null">
      or o.owner_user_id = #{scope.userId}
    </if>
  )
</if>
那个 1 = 0 还是上一篇那条原则:范围解析出来什么都没有,结果应该是查不到,不是查全部。
新出现的代价是索引。上一篇给的索引是 (tenant_id, dept_id, create_time),现在 where 里是三个不同列的 OR,这个复合索引用不上了——MySQL 可能尝试 index_merge 把几个单列索引做 union,但一旦叠上 ORDER BY ... LIMIT,优化器经常直接放弃走索引。所以三维范围不能只当权限问题处理,它同时是个查询设计问题。
我一般会先按主归属维度拆接口:订单列表按部门判,门店报表按门店判,渠道门户只带 channel_id。一个查询只扛一个维度,索引就还是单维复合索引。多数中小系统到这一步就够了。
碰上真的必须出一个并集列表的时候,就把范围解析成 id 集合落到临时表,再 join。范围解析本来一次请求只算一遍(上一篇那个带版本号的本地缓存),把结果集物化一次,比让优化器去猜 OR 划算。
改造成本最低的一条是给每个维度各建一个 (tenant_id, xxx_id) 索引,接受 filesort,用分页把扫描行数限住。数据量上百万之后这条最不靠谱,我拿它先顶过两次。
还有一个容易忽略的:外部账号走的是另一条链路。渠道的店长不是你的员工,他的可见范围只有 storeIds,字段还要再裁一层(他看不到你的成本价,也看不到别的渠道的返佣)。这种查询最好物理分开,外部门户一套接口,内管一套接口,别共用一个列表 Service。共用意味着每个改动都要同时想清楚两类人,而这种“同时想清楚”维持不了几个月。
storeIds 有两个来源:
Set<Long> stores = new HashSet<>(userStoreMapper.storeIdsOf(userId));
stores.addAll(storeMapper.idsUnderDepts(scope.deptIds()));
第一条是“这个人直接负责哪些门店”,店长、督导都算;第二条是“他名下部门子树里有哪些门店”,区域经理靠这一条拿到全区。第二条意味着范围解析要多查一次关系表,代价是它跟着划转即时变化。
于是会出现一个看着矛盾、其实正好对的现象:把 S1 划给 B 区之后,A 区主管的列表里当天就没有 S1 的单了,但那些单的 store_id 和 dept_id 一个字都没变。可见范围按当前,历史归属按快照,两件事各走各的。写报表的时候千万别把这两个混成一个口径,混了就会出现“人调走了,业绩既不在新部门也不在老部门”。
会算钱的主体不能挂在组织树上
代理商要有自己的 id、自己的生命周期,合同号也归它自己,不能跟着部门树一起挪。
两件事的节奏不一样。组织调整是常态,一年三四次,调完只要“以后”对就行;结算一个月才一次,但一次算错要么多付要么少付,代理商对账当天就发现。返佣挂在部门树上,等于让一个月结一次的钱,跟着一年三四次的调整跑。
落到表上,先说单据。成交那一刻把归属写死,之后不跟着组织树动:
ALTER TABLE biz_order
  ADD COLUMN dept_id    BIGINT NOT NULL COMMENT '成交时操作人的行政部门,快照',
  ADD COLUMN store_id   BIGINT NULL     COMMENT '成交门店;纯线上或总部直营为空',
  ADD COLUMN channel_id BIGINT NULL     COMMENT '引流代理商,可空';
上一篇说过“快照还是跟着人走”,这里的答案一样:跟,历史业绩就改了归属;不跟,就要承认它是快照。三个字段都存,不要靠 join 回来。存储成本几乎为零,回溯成本极高——你没法从一棵已经变过的树上还原出当时的形状。
store_id 允许为空,是因为纯线上单和总部直营单本来就没有门店。写成 NOT NULL 再拿 0 当哨兵,等于给每个查询埋一个 store_id != 0,漏一处就把线上单算进某家店;报表按门店分组时,0 还会变成一个真实存在的门店行。让空值表达“没有门店归属”,按门店过滤的账号自然看不到这些单,总部报表单独按 store_id is null 分组,语义是对的。
另一处是结算明细,存快照,不存引用。生成结算单那一刻,把归属主体 id、金额、适用的返佣规则版本一起写进明细行。之后组织怎么调、规则怎么改,已生成的明细不重算。要重算也得留痕:只重算未付款的明细,并且记一个 recalc_reason。
顺带把报表的两种口径分开写。业绩、提成、返佣这类要发钱的,读单据上的快照,因为它对应的是“当时承诺给谁”;管理看板、门店健康度这类看现状的,join 当前关系表,因为它对应的是“现在该谁负责”。两种都要,那就让接口名和列名把口径带上,比如 performanceBySnapshot 和 coverageByCurrent,别都叫 getDeptReport。名字省下的那几个字符,最后都会变成财务和运营在群里争论哪个数是对的。
判断这条做没做,问一句就够了:财务让你“把上个月的返佣重算一遍”,你敢不敢点那个按钮。敢,说明明细里有快照;不敢,说明重算出来会和已付款对不上,因为中间调过一次组织。
把门店从 A 区划到 B 区,看哪几个数变了
上面这些是不是真分开了,不用看代码,做一次划转就知道。
在测试租户里造一批 30 天前的数据:门店 S1 挂在 A 区,A 区有个代理商 C1 给 S1 引过流,S1 有库存、有履约单,A 区主管有一个列表权限。
然后把 S1 从 A 区划到 B 区:往 biz_store_dept 插一条新区间,旧区间把 valid_to 截掉,再把 biz_store.ops_dept_id 刷成 B 区。判定和历史都读区间表,那一列漏刷只会让列表页显示旧归属。
然后对着看几个数。
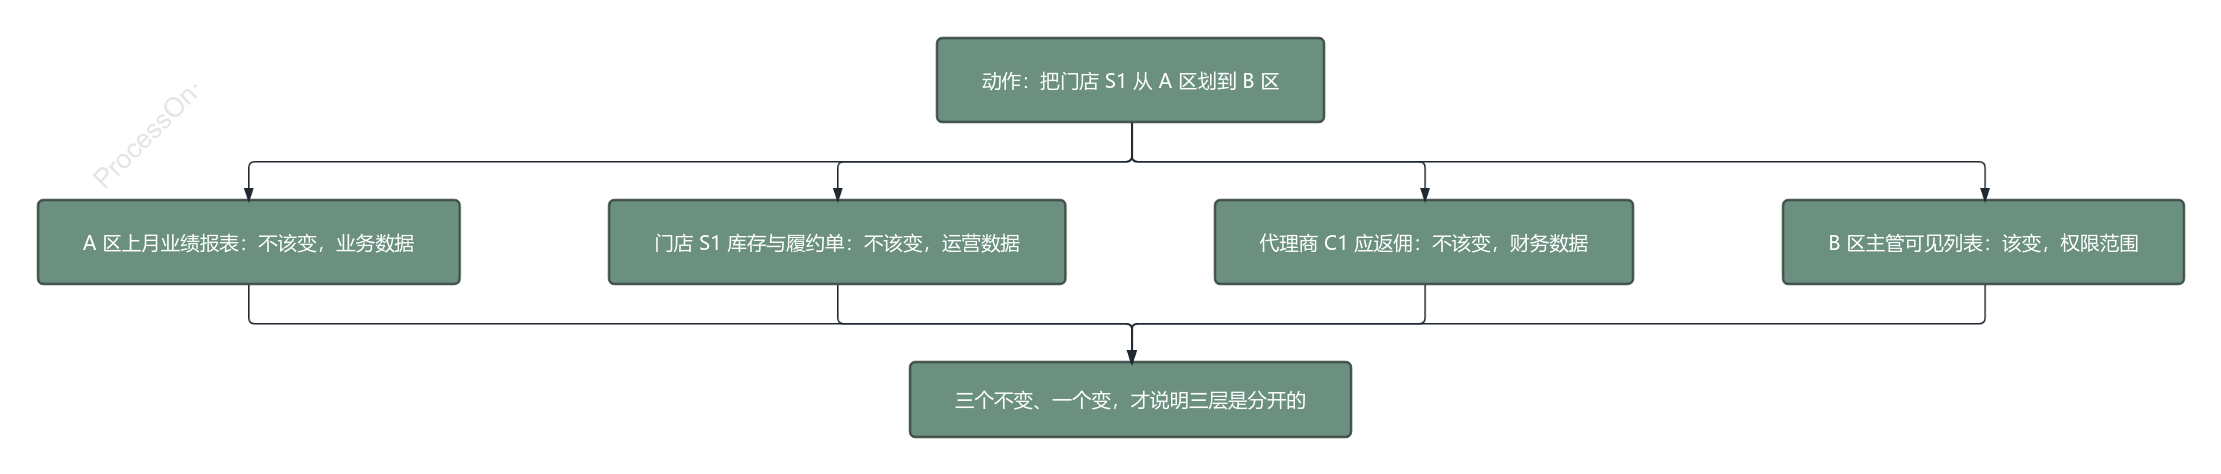
图 2:划转动的是 biz_store_dept 里的一条区间,加上门店那一列快照,报表、库存、返佣三条支路都不该被它带走。
A 区上个月的业绩报表不该变。变了说明报表在 join 当前归属,而不是读单据上的 dept_id 快照。门店 S1 的库存和履约单不该变,门店 id 没动过,变说明有人把 store_id 当成了部门 id 在用。代理商 C1 的应返佣不该变,它属于渠道和门店的关系,跟区域划分无关;这条要是变了就是钱付错了,另外两条明天再查也来得及。
该变的只有一个:B 区主管的可见列表,从划转生效日开始能看见 S1,A 区主管从同一天起看不见。这是行政范围,本来就是“从今天起”的语义。
三个不变、一个变,三层才是分开的。这个演练五分钟,比读一遍代码管用,而且它同时把 01、02 两篇的东西一起验了——租户上下文、数据范围、快照字段。
已经塞在一张表里怎么办。顺序是固定的,反了就有的忙。
先建新表,从 sys_dept 按 type 回填,回填时把跨类的 parent_id 链断掉,并留一张映射表记下 old_dept_id → new_id。然后单据表加三个归属列,用映射表加当前关系回填一次,回完就冻结,历史单据不再改。第三步双写:新建门店、新建渠道的写路径同时写旧表,保住还没切的读路径。第四步按接口切读,先切只读报表,最后切结算。删旧字段之前跑一次对账:旧表 type = 2 的行数、新表门店数、带 store_id 的订单数,三个数关系对得上才动手。
还有一条节奏上的建议:拆表和改权限模型不要放在同一个版本里。两件事都会动 where 条件,一起上线的话,出了问题是分不清谁的。
会员等级和标签不在这一层
三层讲的是内部结构和外部主体。会员等级、标签、区域圈选是营销维度,它决定推什么券,不决定谁能看哪行数据;硬塞进同一张树表,就是 type 那一列的翻版。真集团的多法人和账套也不在这里,那是财务系统的事,比这里难一个量级。
字段名按你们习惯改。已经压在一张表里、历史报表跟着划转跑的,先看 sys_dept 里 type、parent_id 和门店属性是不是挤在同一行;是,就按上面的顺序拆。拆完别急着删旧字段,拿一家门店做一次划转,只看那四个数:三个不变、一个变,才算拆对。
系列:上一篇 权限系统:RBAC 不够用的地方,数据权限怎么补 | 下一篇 多租户系统最容易出事的 8 个位置 | 相关 蓝领招工难在实名和日结