多租户不是加一个 tenant_id:三种隔离模型与选型
今年线上出过一次。我们的系统服务几十家客户,新加了导出订单的功能,测试是过了的,运营一点“导出订单”,导出来的是全量数据。排查下来是这样:接口把任务丢进线程池就返回了,异步线程里没有租户上下文,MyBatis 拦截器拿不到 tenant_id,SQL 没加条件,导出的自然是全量。文件再传到公共目录,半小时后客户打电话过来。
这个 bug 不只是漏测,是测错了对象。导出当时是测过的:点下去返回 200,任务提交成功,日志里没报错,怎么看都是通过。但导出这类功能的产物是那个文件,不是那个响应,断言应该落在文件里有多少行、这些行属于哪个租户。把断言从响应改成产物,同一个用例会当场红。“测过了”和“测对了”是两件事,这条是我自己踩出来的。
这不是什么高级攻击,就是某条执行路径没覆盖到:那个导出任务拿不到租户的时候没有报错,而是按“没有租户条件”跑下去了。字段好加,难的是证明每条路径都没漏。
三种模型,先看成本和失效方式
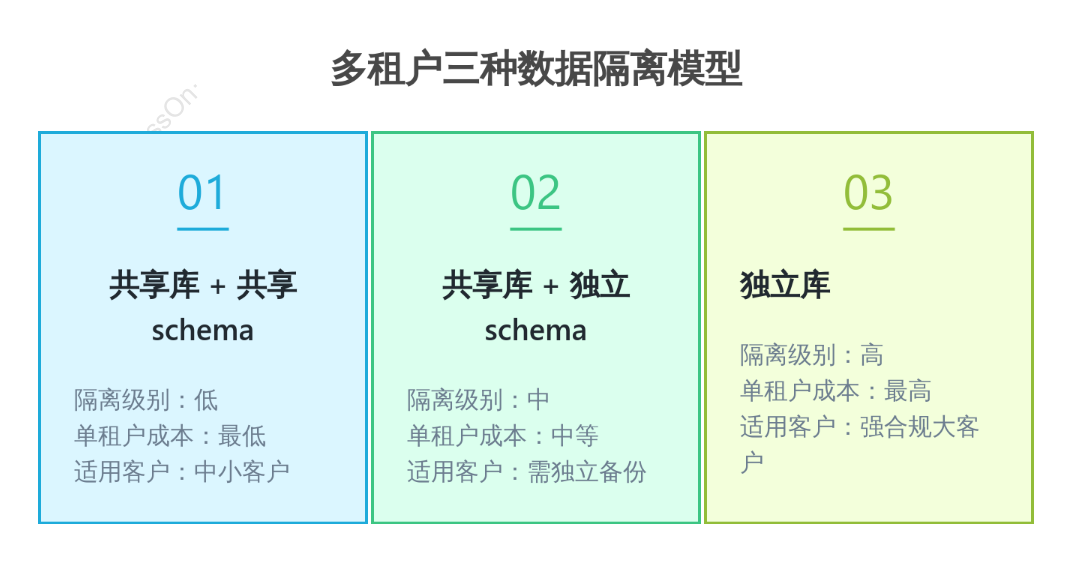
图 1:三种数据隔离模型。
先按 MySQL 来说:MySQL 里 schema 和 database 是同一个东西,所以模型 B(独立 schema)在 MySQL 下就是“同一个实例、每个租户一个 database”,换成 PostgreSQL 才是“同一个库里的不同 schema”。模型 C(独立库)指每个租户一套独立数据库,可以是独立实例,也可以是独立 RDS。
共享表
共享表是最常见的做法。所有租户共用一套表,每条业务数据带 tenant_id,查询、更新、删除时由应用层加租户条件。它的好处很直接:一套表、一套连接池、一次迁移,租户从 10 家涨到 1,000 家,数据库数量不变。坏处也很直接:隔离只发生在应用层,一条漏加条件的 SQL、一个绕过拦截器的脚本,就可能把 A 租户的数据带给 B 租户。MySQL 又没有 PostgreSQL 那种行级安全策略,数据库层给不了兜底,全靠代码和测试撑住,这是很多团队后来转向独立 schema 的真实原因。
它适合中小客户为主、单租户数据量不大、没有强合规要求的场景。客户如果明确要求独立备份、独立恢复、独立升级,或者单租户数据量已经会拖累别人,就别硬撑。
独立升级这条常被忽略。共享表下你只有一次发布机会:新版本上线,所有租户同时被升上去,代码还得同时兼容各家已经改过的字段和状态。有一个租户提了定制需求,你就得在共用表里加一列,或者在自己的库里开一个例外分支,做上十几家之后,这套“一套代码”会变成一堆 if (tenantId == 3)。这是共享表模式里最容易积累技术债的地方。
独立 schema
独立 schema 是同一个实例、每个租户一个 database,表结构一样,应用按当前租户切换连接。它比共享表多了一层命名空间:备份可以按库做,恢复可以只恢复一个租户,个别租户的表结构也能做少量定制。代价是连接池、迁移脚本、监控都要按租户复制一份。租户到几百家,光“每个库都跑一遍 DDL、跑完记下哪个还没跑”就要排班。
它适合中型客户、需要独立备份或迁移、租户数量可控的团队,大概 50 到 500 家。坑主要不在建库,在切换连接:连接池和事务的顺序弄反了,就会拿着 A 租户的连接去查 B 租户的数据,顺序那段后面单独讲。
独立库
独立库是每个租户一套数据库,通常也意味着独立实例、独立账号、独立备份,甚至独立部署。隔离最彻底,一个租户出故障不会影响别人,客户也最容易接受“这是你的库”。
代价是每个租户一套连接池、一套监控、一套迁移、一套故障处理。10 家还能手工管,100 家就需要平台化。独立库也不等于自动安全,路由写错照样连到别人的库。
| 维度 | 共享表 | 独立 schema | 独立库 |
|---|---|---|---|
| 隔离强度 | 逻辑隔离 | 逻辑隔离 + 命名空间 | 物理隔离 |
| 单租户成本 | 最低 | 中等 | 最高 |
| 运维复杂度 | 低 | 中 | 高 |
| 独立备份/恢复 | 难 | 可以按库做 | 最容易 |
| 跨租户统计 | 直接查 | 需要聚合 | 通常要走数仓 |
| 迁移影响面 | 一次影响全部租户 | 可按租户分批 | 完全独立 |
| 典型风险 | 漏加条件导致全量泄露 | 连接切换、迁移遗漏 | 成本、连接数、版本碎片 |
| 适用 | 中小客户、标准化产品 | 中型客户、需独立备份 | 大客户、强合规、私有化 |
怎么选:先算运维账
我一般先问几个问题,而不是先问“用哪种架构”:
- 最大的一个租户,数据量和请求量可能是平均值的多少倍?
- 客户有没有明确要求独立备份、独立恢复、等保或者数据不出境?
- 交付方式是 SaaS、私有化,还是源码买断?
- 团队里有没有人愿意长期维护 N 套库、N 个连接池、N 次迁移?
- 未来一年,付费租户大概是什么数量级?
这些答案通常会把选择压到很小。这张表是我自己用的粗略刻度,只用来判断现在该不该为隔离付那笔运维成本:
| 情况 | 建议 |
|---|---|
| 租户少于 100 家,单租户数据量 10GB 以内,没有强合规要求 | 共享表,把 tenant_id、索引和测试做扎实 |
| 客户要求独立备份或迁移,租户在 50 到 500 家 | 独立 schema,用较低成本买到按租户恢复的能力 |
| 强合规、私有化、源码买断,或单租户数据量超过 100GB | 独立库,重点转向部署、备份、升级的标准化 |
前两行有重叠:60 家租户、没有强合规、客户也没提独立备份,我按共享表处理。租户数量本身不是触发条件,客户开口要独立备份或独立迁移才是。
提前上独立库是常见的误区。独立库的成本不是多一个数据库,是多一套备份、监控、迁移、连接池,再加一个独立的故障域。规模还撑不起这套运维时先做共享表,但把拆库的路留着,具体是三件事:tenant_id 从第一天就写进每张表,将来拆库、合并、回溯数据都靠它;跨租户统计走只读副本,不要在主库上做大范围 join;报表和数据访问层不要假设“全站就一个库、一个数据源”。
拆库的信号一般很具体:某个租户的数据量占到总库的 30% 以上;备份窗口长到影响业务;一个租户的慢查询开始拖累别人;合同里明确写了独立数据库;或者单次迁移已经不敢在工作日做。
交付方式也会把答案定死。源码买断加私有化,客户买的就是边界,这种合同下讲独立库最省事;你自己托管的多租户 SaaS,共享表加严格的应用层控制,账算得过来。
共享表怎么落地
共享表能用,但前提是“不漏”这件事有人在做,不是靠运气:字段、索引、上下文、SQL 改写、测试,五件少一件就留口子。开头那个 case 就漏在上下文和测试这两件上。租户没传进线程池,测试又只断言了接口返回。
表结构
CREATE TABLE biz_order (
  id          BIGINT       NOT NULL PRIMARY KEY,
  tenant_id   BIGINT       NOT NULL,
  order_no    VARCHAR(32)  NOT NULL,
  amount      DECIMAL(18,2) NOT NULL,
  created_at  DATETIME     NOT NULL,
  UNIQUE KEY uk_tenant_order (tenant_id, order_no),
  KEY idx_tenant_created (tenant_id, created_at)
);
tenant_id 必须 NOT NULL,不要给默认值 0。默认值会把忘记赋值变成一条合法数据,而不是一个错误。
唯一索引要把 tenant_id 放在最前面。不同租户可以有相同的订单号,同一个租户内不能重复;只建 UNIQUE(order_no),第二个租户下单就会撞唯一键。
联合索引尽量以 tenant_id 开头。多租户系统里几乎所有查询都带租户条件,索引不带上它,数据量一大就是全表扫描。跨租户统计是另一条链路,一般走只读副本或者数仓,别占着主库。
外键要不要建看团队习惯;如果建,关联键也应该是 (tenant_id, id) 这种复合形式,避免跨租户关联。tenant_id 的类型要统一成 BIGINT,别一张表 BIGINT、另一张表 VARCHAR:数字主键索引更窄,将来导数据、拆库、跟计费和租户表 join 时都不用做类型转换。
上下文和过滤器
租户 ID 不能从请求参数里取。用户把 tenantId=2 改一下,就能尝试读别人的数据。正确来源是已认证的身份:JWT 里的租户声明、Session 里的当前租户,或者服务端根据用户 ID 查出来的成员关系。
public final class TenantContext {
    private static final ThreadLocal<Long> HOLDER = new ThreadLocal<>();

    private TenantContext() {
    }

    public static void set(long tenantId) {
        HOLDER.set(tenantId);
    }

    public static long require() {
        Long tenantId = HOLDER.get();
        if (tenantId == null) {
            throw new IllegalStateException("tenant context missing");
        }
        return tenantId;
    }

    public static Long getOrNull() {
        return HOLDER.get();
    }

    public static void clear() {
        HOLDER.remove();
    }
}
这里故意让 require() 抛异常,而不是返回 0 或者查全部。开头那个导出之所以能生成全量文件,就是因为拿不到租户时走了“没有条件”这一支;换成 require(),那条 SQL 在执行前就抛 tenant context missing,任务失败,但数据没漏。漏条件和加错条件是两种故障:加错条件最多是查不到东西,漏条件就是越权。
过滤器负责解析、校验和清理:
@Component
public class TenantFilter extends OncePerRequestFilter {

    private final TenantMembershipService membershipService;

    public TenantFilter(TenantMembershipService membershipService) {
        this.membershipService = membershipService;
    }

    @Override
    protected void doFilterInternal(HttpServletRequest request,
                                    HttpServletResponse response,
                                    FilterChain chain)
            throws ServletException, IOException {
        Long tenantId = TenantResolver.fromAuthenticatedPrincipal(request);
        if (tenantId == null) {
            response.sendError(HttpServletResponse.SC_BAD_REQUEST, "tenant missing");
            return;
        }
        if (!membershipService.belongsTo(CurrentUser.id(), tenantId)) {
            response.sendError(HttpServletResponse.SC_FORBIDDEN, "tenant forbidden");
            return;
        }

        TenantContext.set(tenantId);
        try {
            chain.doFilter(request, response);
        } finally {
            TenantContext.clear();
        }
    }
}
TenantResolver 和 CurrentUser 是示意,换成你项目里的认证实现。关键就三件事:来源可信、校验成员关系、finally 清理。过滤器放在认证之后、业务之前;用 Spring Security 的话,直接从 SecurityContext 取用户,别再解析一遍 token。
SQL 改写
如果团队用 MyBatis-Plus,最省事的是 TenantLineInnerInterceptor:
@Configuration
public class MybatisPlusConfig {

    private static final Set<String> GLOBAL_TABLES =
            Set.of("sys_tenant", "flyway_schema_history");

    @Bean
    public MybatisPlusInterceptor mybatisPlusInterceptor() {
        MybatisPlusInterceptor interceptor = new MybatisPlusInterceptor();
        interceptor.addInnerInterceptor(new TenantLineInnerInterceptor(new TenantLineHandler() {
            @Override
            public Expression getTenantId() {
                return new LongValue(TenantContext.require());
            }

            @Override
            public String getTenantIdColumn() {
                return "tenant_id";
            }

            @Override
            public boolean ignoreTable(String tableName) {
                return GLOBAL_TABLES.contains(tableName);
            }
        }));
        return interceptor;
    }
}
它会自动给查询、更新、删除加租户条件,给插入补 tenant_id。但自动不等于正确,这几类要把改写后的 SQL 打印出来单独看:
INSERT ... SELECT、ON DUPLICATE KEY UPDATE、子查询、UNION,不同 MyBatis-Plus 版本的处理方式不完全一样;- 自己已经手写了
tenant_id的报表 SQL,被再追加一次会变成tenant_id = ? AND tenant_id = ?,两个值不一致时直接查空; - 存储过程、定时脚本、数据修复脚本不经过这个拦截器,条件得自己带;
- 多表 JOIN、列名重复时,租户条件可能被加到错误的表上。
办法很笨但管用:把执行的语句打出来看一遍,比如 mybatis-plus.configuration.log-impl=org.apache.ibatis.logging.stdout.StdOutImpl,或者接 P6Spy。别相信“它应该加上了”。
原生 MyBatis 可以自己写 Executor 拦截器,用 JSqlParser 改写 SQL;也可以选更笨但更可控的办法:所有 Mapper 方法显式传 tenantId。
@Select("select * from biz_order where tenant_id = #{tenantId} and id = #{id}")
Order findById(@Param("tenantId") long tenantId, @Param("id") long id);
显式写法啰嗦,但代码审查时一眼能看出有没有带租户条件。表不多、团队不大的时候,先用显式写法把边界跑通,再考虑自动拦截。自动拦截可以兜底,但别把它当成唯一的安全假设。
跨租户查询和测试
平台运营需要看全局数据,这个需求合理,但要有边界。单独建一个跨租户查询的 Mapper,方法上标 @InterceptorIgnore(tenantLine = "true"),不要在整个 Service 上关闭;只允许只读查询,写操作仍然走租户上下文;记录操作人、查询条件、返回条数、时间,审计日志单独存;能走数仓就走数仓,别在业务库上做全量跨租户聚合。
最危险的是给超级管理员一个“忽略租户”的开关,普通请求里也能打开。权限系统应该决定能不能跨租户,而不是让业务代码自己决定这次要不要过滤。
至少写一个集成测试:租户 A 插入一条订单,切到租户 B,用同一个订单号查询,断言查不到;再切回 A,断言能查到。然后把这个测试扩展到更新、删除、导出、异步任务,导出那条要断言文件里的行数,接口返回 200 不算通过(原因见开头那个 case)。每次新增一条绕过常规链路的入口,就补一条测试,挂到 CI 上。
独立库怎么落地
独立 schema 或独立库,代码上最核心的是路由数据源:
public class TenantRoutingDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return TenantContext.getOrNull();
    }
}
启动时把租户 ID 和对应的 DataSource 注册进去,每个租户一个连接池。租户少可以全量初始化,租户多要懒加载,并设置空闲回收。
这里有三个容易出问题的地方。一个是 AbstractRoutingDataSource 的目标数据源 Map 默认不是为运行时频繁增删设计的,新租户开通后要刷新,删租户后要关闭连接池,最好自己封装一个线程安全的注册表。
另一个是连接池数量要算总账,这笔账很多团队是上线之后才被 MySQL 提醒的。HikariCP 默认 maximumPoolSize 是 10,50 个租户就是 500 个连接,再乘上应用实例数;而 MySQL 8 的 max_connections 默认只有 151(SHOW VARIABLES LIKE 'max_connections' 看自己实例的实际值)。要么把每个租户的池压到 2 到 3 个连接,要么把实例数和租户数一起写进容量规划,顺便把 minimumIdle 也降下来,不然空闲时也在占位。连接数打满之后报的是数据库层面的 Too many connections,跟业务代码没关系,半夜看到容易往错的方向查。
第三个是事务顺序。路由发生在获取连接的时候,Spring 的事务代理在进入方法前就开启了事务,连接通常也在这时绑定到线程。如果你在方法内部才设置租户上下文,路由可能已经用旧租户拿到了连接。正确顺序是:过滤器设置上下文 → Controller → @Transactional → 获取连接 → 路由到目标库。不要在事务内部切换租户,也不要在同一个事务里操作两个租户的库。确实需要跨租户写,拆成两个事务,或者用应用层补偿。
迁移也不再是跑一次,而是跑 N 次:
- 用 Flyway 或 Liquibase 按租户执行,记录每个租户的版本。
- 迁移前备份,先在一个租户上灰度,再批量执行。
- 某个租户失败就停下来,不要带病继续。
- 备份要按租户可恢复,定期做恢复演练,而不是只看备份文件大小。
租户下线也要有流程:先导出数据,确认保留期,再删库、删对象存储里的文件、删缓存键、关连接池。只删数据库里的行不算完事,导出文件还挂在桶上、缓存里还留着旧数据,客户问“我们的数据删干净了吗”就答不上来。合同里写了个人信息和留存期的,这一条一般单独列。
几个容易漏的地方
前面讲的都是主链路。下面这四类入口不在请求线程里,也没有过滤器,得单独处理:
| 入口 | 常见问题 | 处理方式 |
|---|---|---|
| 异步线程池 | ThreadLocal 不会自动传过去 |
TaskDecorator 或 runAs |
| 定时任务 | 没有请求,也就没有过滤器 | 遍历租户,显式设置上下文 |
| MQ 消费 | 消息里没带租户,消费端查全量 | header 带 tenant_id,消费前校验 |
| 文件、缓存、日志 | 路径或 key 没有租户维度 | 按租户加前缀,签名 URL 限制对象 |
ThreadLocal 不会自动传到线程池,InheritableThreadLocal 也只在线程创建时继承,线程池里的线程早就创建好了,靠它不可靠。给线程池加 TaskDecorator:
@Bean
public TaskDecorator tenantTaskDecorator() {
    return task -> {
        Long tenantId = TenantContext.getOrNull();
        return () -> {
            try {
                if (tenantId != null) {
                    TenantContext.set(tenantId);
                }
                task.run();
            } finally {
                TenantContext.clear();
            }
        };
    };
}
定义成 Bean 还不够,要设置到实际使用的线程池上,例如 executor.setTaskDecorator(...);项目里有多个线程池,统一用 TaskExecutorBuilder 配置,避免漏掉某一个。如果任务内部还会切换租户,清理时就要恢复外层上下文,不能简单 clear()。线程池是复用的,残留的租户 ID 会带进下一个任务。
这里还有个连带效果:只要 TenantLineHandler 里用的是 require(),上下文没传过去时任务会直接抛异常。客户投诉“导出失败”比投诉“我的订单被别人下载了”便宜得多,这也是我宁可让任务失败也不想让它查全量的原因。
定时任务没有请求上下文,租户只能自己给,别默认“系统任务可以查全部”:
@Scheduled(cron = "0 0 2 * * ?")
public void syncAllTenants() {
    for (Long tenantId : tenantService.activeTenantIds()) {
        TenantContext.runAs(tenantId, () -> syncService.syncOrders());
    }
}
runAs 要保存并恢复上一个上下文,保证嵌套调用和异常情况下都能回到原状态。把这段放进 TenantContext:
public static void runAs(long tenantId, Runnable action) {
    Long previous = HOLDER.get();
    try {
        HOLDER.set(tenantId);
        action.run();
    } finally {
        if (previous == null) {
            HOLDER.remove();
        } else {
            HOLDER.set(previous);
        }
    }
}
任务失败要按租户记录,不能一个租户失败就静默跳过,否则第二天你只会看到“同步完成”,但某个客户的数据一直没动。
MQ 也是同一个道理。生产者在消息头里带 tenant_id,消费者取出后设置上下文,再执行业务。消费端还要校验消息里的租户和业务数据是否一致;幂等键带上租户,避免两个租户的相同业务号互相覆盖。
文件路径按租户隔离。我那次的第二步就出在这个文件上:导出结果写在一个公共目录里,知道路径的人都能拿。
tenant/{tenantId}/export/{yyyyMMdd}/{uuid}.xlsx
对象存储的签名 URL 要限制到具体对象,不要给公共读桶。缓存键加租户前缀,例如 t:{tenantId}:order:{orderId},删除和失效也要按租户范围做。日志里加 tenantId 到 MDC,排查问题时能按租户过滤;但不要把手机号、身份证号、完整订单内容打进日志。
还有几个同类入口:WebSocket、SSE、CompletableFuture.supplyAsync 默认使用的公共线程池、分布式锁的 key、限流规则的 key。判断方法很土:只要它不在当前请求线程里,就问一句“租户上下文怎么过去”。
上线前我会检查什么
- [ ] 所有业务表都有
tenant_id且为NOT NULL,唯一索引和常用查询索引都以它开头。 - [ ] 租户 ID 来自认证身份,不来自 query、body 或前端传入的 header。
- [ ] 过滤器在
finally中清理上下文。 - [ ] 绕过拦截器的 SQL 有白名单和注释说明;跨租户查询只读,并且记审计日志。
- [ ] 异步线程池、定时任务、MQ 消费、文件导出都有租户传递测试。
- [ ] 缓存键、对象存储路径、分布式锁 key 都带租户维度。
- [ ] 新租户开通、迁移、备份、恢复、下线都有可执行流程。
- [ ] 开过 SQL 日志,抽查过拦截器改写后的语句,尤其是子查询、
UNION、INSERT ... SELECT。 - [ ] 独立库模式下算过连接数总账:租户数 × 每池最大连接 × 实例数,小于实例的
max_connections。 - [ ] 至少有一条集成测试证明 A 租户查不到 B 租户的数据。
清单里最容易被忘记的是异步和导出:它们不在请求线程里,平时也没人专门去点。新功能上线前,把这两个入口各手动跑一遍,看日志里的 tenantId 和导出文件的路径对不对。
最后说清楚边界
这篇文章讲的是数据隔离,不是完整的 SaaS 架构。租户计费、套餐、配额、试用、租户生命周期、跨租户权限模型,都得单独设计。文中的代码是骨架,不是能直接复制上线的完整实现;MyBatis 版本、SQL 改写规则、连接池参数,都要用你真实的表结构和 SQL 去验证。
开头那个导出事故是真实的线上问题,客户、行业、公司都隐去了,规模和过程没改:几十家客户、异步线程池、全量订单文件、公共目录。后面的判断都是从这个事故往外推的,不是从文章结构需要往外推的。
如果你正在做行业系统的多租户改造,或者客户要求私有化、独立备份、源码买断,可以把表结构、租户规模和部署方式发我。我先帮你判断该用哪种隔离模型,再谈改造要动多少东西。
系列:下一篇 权限系统:RBAC 不够用的地方,数据权限怎么补 | 相关 多租户系统最容易出事的 8 个位置、私有化部署的最小交付包,拔掉网线还能装起来才算