主流程演示得再顺,客户还是要先导一个 Excel
现在报价,我会把导入、导出、打印单独列成三个报价项,验收前一天先拿客户真实的文件和那台打印机自己走一遍。这三样,是那天验收现场补的课。
验收那天,客户坐下来,没有点我准备了一周的下单流程。他从包里掏出一个 U 盘,打开一个叫“商品资料-最终版.xlsx”的文件,问能不能直接导进去。导完又让我把当月的销售明细导出来,说要跟自己的表对一下。最后带我去仓库,打了一张拣货单,看了看边距,说“这个往左偏了两毫米”。主流程讲了半个小时,客户点头;导入、导出、打印都做完,他才开始问什么时候能上线。这三样排在了开发计划的最后。
验收现场,先被打开的是 Excel
开发的时候,主流程是主角:下单、支付、发货、退款,每一步都能演示。验收的时候,客户用的是另一套顺序。导入关系到他明天能不能把老资料搬进来,导出关系到他的会计能不能做账,打印关系到仓库那台针式打印机还能不能用。它们都不在“业务闭环”里,却都在客户每天的工作里。主流程出问题,客户会提 bug;Excel 出问题,客户会说你这套系统没法用。主流程讲得再顺,也只是入场券。
报价时最容易漏的也是它们。一个导入功能,写解析半天,处理各种脏数据要两天;一个导出,小数据量半天,异步下载加权限要两天;一张套打单据,调边距能调一下午。这些工作量不写在报价里,最后都变成交付期的加班。
导入的难点在错误行
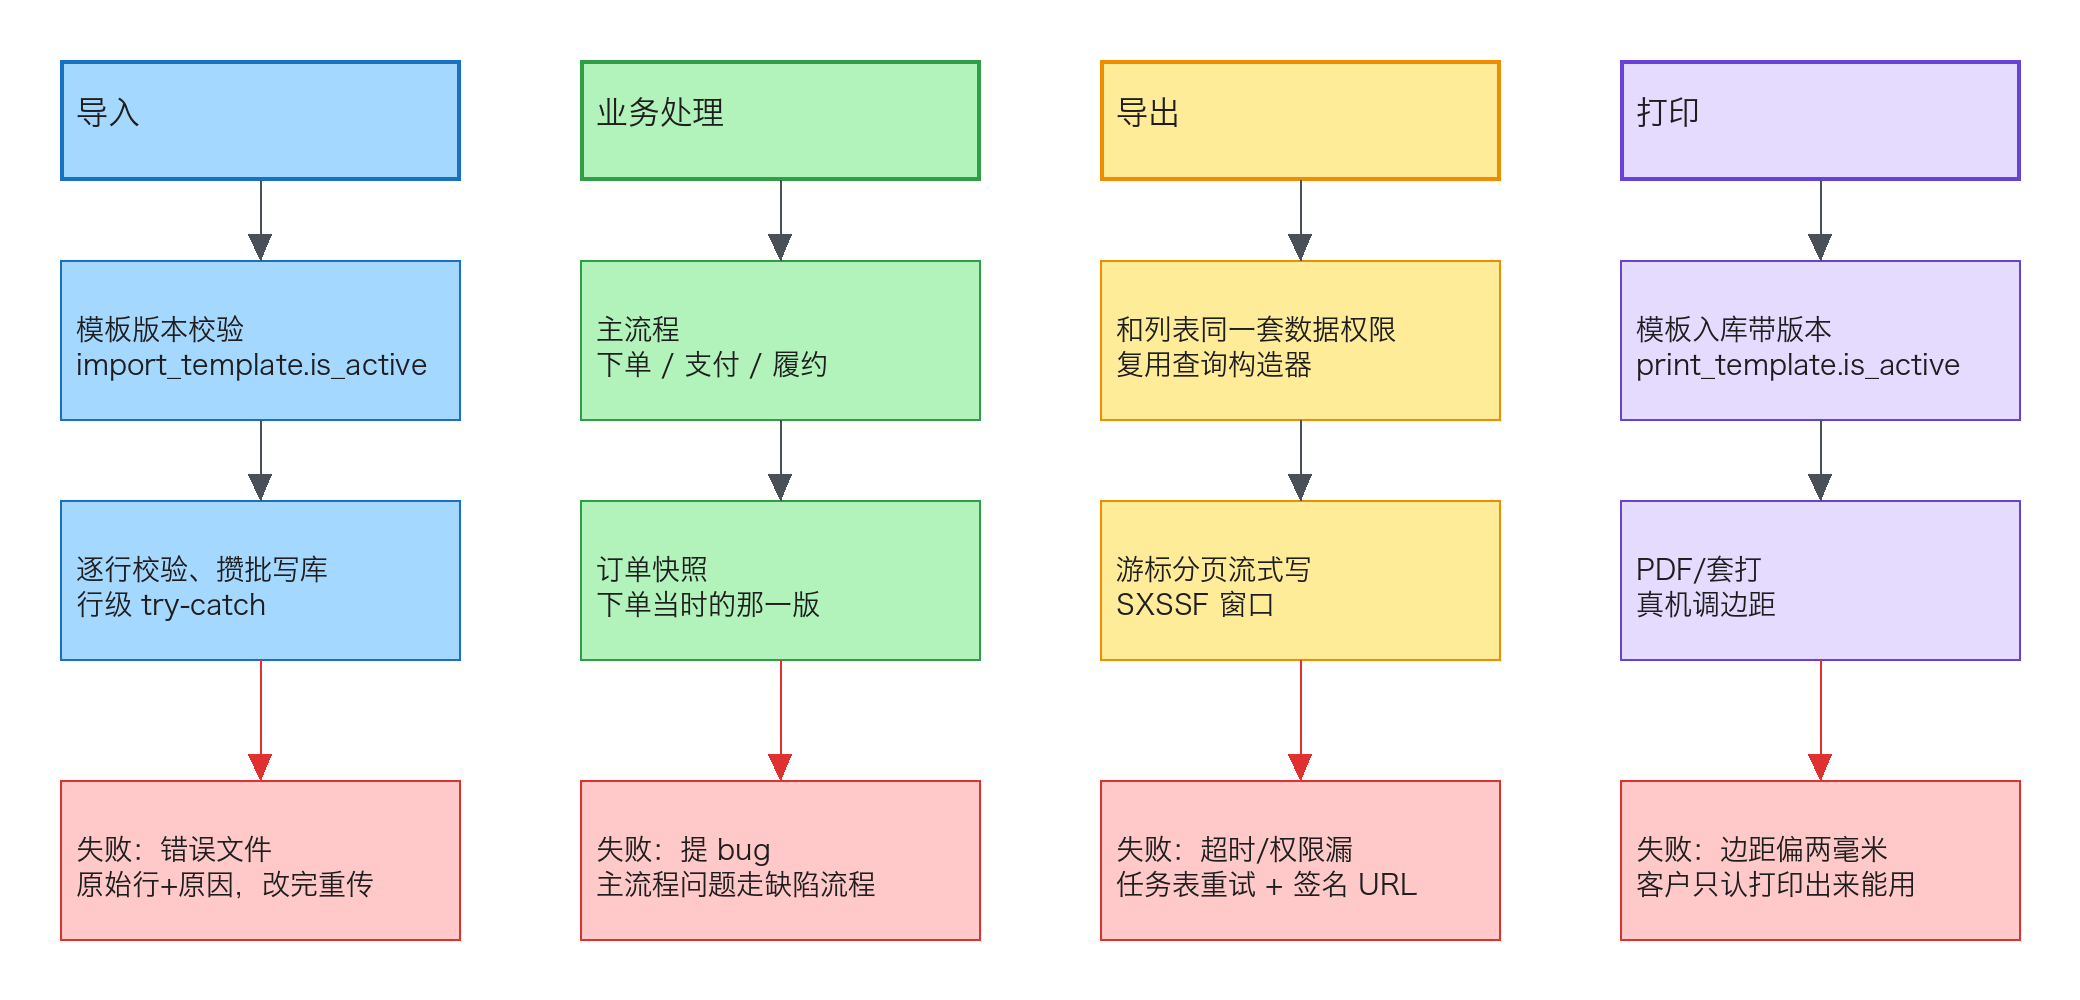
把 Excel 读成对象不难,难的是读错的时候,用户知道该改哪一格。模板要带版本。客户手里的模板可能是一年前从别的系统导出的,列名对不上,顺序也不一样;模板文件首行放 template_code:version,和 import_template 里 is_active 的那行对——没有这张表,校验就没有比对对象,错误文件也没地方拿列定义。不匹配就明确告诉用户去下载新版,别硬按列序号读。按列名读,未知列忽略,缺必填列直接拒绝整份文件。
模板要带版本
模板本身也是一份交付物。每一列写清楚字段名、是否必填、格式、枚举值,给一行示例数据,再给一份数据字典。客户填错的时候,错误提示要能对上模板上的列名,而不是数据库字段名。
CREATE TABLE import_batch (
  id           BIGINT PRIMARY KEY AUTO_INCREMENT,
  tenant_id    BIGINT NOT NULL,
  template_code VARCHAR(64) NOT NULL,
  version      VARCHAR(16) NOT NULL,
  file_name    VARCHAR(255) NOT NULL,
  file_path    VARCHAR(500) NOT NULL,  -- 原始文件落盘位置,清理和取证都靠它
  file_sha256  CHAR(64) NOT NULL,
  attempt_no   INT NOT NULL DEFAULT 1,  -- 同一文件第几次上传,FAILED 放行重传时加一
  total_rows   INT NOT NULL DEFAULT 0,   -- 解析完成才回填
  processed_rows INT NOT NULL DEFAULT 0, -- 攒一批更一次,前端显示「已处理 N 行」
  ok_rows      INT NOT NULL DEFAULT 0,
  fail_rows    INT NOT NULL DEFAULT 0,
  status       VARCHAR(16) NOT NULL DEFAULT 'PARSING',  -- QUEUED / PARSING / COMPLETED / PARTIAL / FAILED / CANCELLED
  expire_at    DATETIME NULL,
  created_by   BIGINT NOT NULL,
  created_at   DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  UNIQUE KEY uk_file (tenant_id, file_sha256, attempt_no)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE import_error (
  id           BIGINT PRIMARY KEY AUTO_INCREMENT,
  batch_id     BIGINT NOT NULL,
  row_no       INT NOT NULL,
  column_name  VARCHAR(64) NULL,
  raw_value    VARCHAR(500) NULL,
  raw_row_json JSON NULL,          -- 整行原样存,错误文件按模板列头展开用
  reason       VARCHAR(500) NOT NULL,
  KEY idx_batch (batch_id),
  KEY idx_row (batch_id, row_no)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE import_template (
  id            BIGINT PRIMARY KEY AUTO_INCREMENT,
  tenant_id     BIGINT NOT NULL,
  template_code VARCHAR(64) NOT NULL,
  version       VARCHAR(16) NOT NULL,
  header_json   JSON NOT NULL,    -- 列名、必填、格式、枚举,校验和错误文件都靠它
  is_active     TINYINT NOT NULL DEFAULT 1,
  created_at    DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  UNIQUE KEY uk_tpl (tenant_id, template_code, version)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
file_sha256 用来判断重复上传,也是排查时的依据:同一个文件传了两遍,先查它最近一条批次,上一批是 COMPLETED 或 PARTIAL 的,第二遍直接告诉用户“这份文件已经导入过”;上一批全失败(FAILED)的要放行重传,attempt_no 加一、新批次照落表——不然第一次解析全错,这份数据就永远进不来。防重复靠这条查询,不靠把 file_sha256 单独建成唯一键,那种键会把 FAILED 的重传一起挡死。业务表上的唯一键仍然要有,文件哈希只是第一道。解析用流式,EasyExcel 的同步全量读叫 doReadSync(),几万行别用它,listener 一行一行给才稳。
合并单元格的坑不在内存,在丢值:纵向合并的区域第二行起该列是 null,非必填列脏数据入库,必填列整文件进错误行,客户以为导了其实没导。EasyExcel 的 listener 一行一行给,校验通过就攒一批写库,失败就把行号、列名、原值、原因写进 import_error。
文件大到几万行,同步接口会超时,浏览器也会先断;改成上传后异步解析,批次状态落库。集群下用 UPDATE import_batch SET status='PARSING' WHERE id=? AND status='QUEUED' 抢占,影响行数为 0 就跳过,两个节点不会同时领一批;listener 每批开头查一次取消标志,用户传错文件当场能停。页面进度用 processed_rows 显示“已处理 N 行”——解析完成前总行数根本不可知,别显示百分比,解析完给一个错误文件。
public class ProductRowListener extends AnalysisEventListener<Map<Integer, String>> {
    private static final int BATCH = 500;
    private final List<ProductRow> buffer = new ArrayList<>(BATCH);
    private final ImportContext ctx;

    @Override
    public void invoke(Map<Integer, String> row, AnalysisContext context) {
        int rowNo = context.readRowHolder().getRowIndex() + 1;
        try {
            buffer.add(ctx.validateAndConvert(row, rowNo));
        } catch (RowInvalidException e) {
            ctx.recordError(rowNo, e.getColumn(), e.getRawValue(), e.getMessage());
        }
        if (buffer.size() >= BATCH) {
            ctx.flush(buffer);   // flush 只负责批量写库
            buffer.clear();      // 清空是 listener 自己的事,不清空下一批连旧带新重插
        }
    }

    @Override
    public void doAfterAllAnalysed(AnalysisContext context) {
        ctx.flush(buffer);
        buffer.clear();
        ctx.finish();
    }
}
部分成功还是全部回滚,要提前定。商品资料这类主数据,建议逐行成功、失败行回一个错误文件;金额、库存这类会影响账的数据,建议整批校验通过再写,或者按审批单一次提交。“逐行成功”的落法要跟攒批对上:攒批前先按业务键内存去重,写库每批一个事务、行级 try-catch,失败行转 import_error,别让一行撞键拖垮五百行。一行里五个格子都错就记五条错误,别让用户改一轮传一次再来一轮。最怕的是脚本一半成功一半失败,用户不知道哪些进了、哪些没进。
导入也要走数据权限。门店店长只能导自己门店的商品,运营能导整个租户;这个判断放在逐行校验里做,进 buffer 之前,别只在页面上把按钮藏起来。解析排队的时候还要能取消,用户传错文件,等十分钟才收到失败提示,比当场报错更让人恼火。
CSV 还有一层坑。客户从财务软件导出的 CSV 经常是 GBK,直接按 UTF-8 读,中文全是乱码;有的文件带 BOM,第一列名前面多一个不可见字符,按列名匹配就找不到。而且 CSV 不走 EasyExcel:用 commons-csv 读,commons-io 的 BOMInputStream 剥 BOM,编码用 juniversalchardet 探测,探测不出来按 BOM→UTF-8→GBK 逐个试读首行,别让用户为编码问题改文件。
错误文件要能直接改。按 raw_row_json 把整行按模板列头展开,后面追加一列“错误原因”,用户改完再传一次。只给一个“第 47 行格式错误”的提示,客户得自己回去找第三列到底是什么。错误文件比错误提示有用。
| 导入时的现象 | 真正的原因 | 处理方式 |
|---|---|---|
| 日期一半是 2024/3/1,一半是 2024-03-01 | 单元格类型混用 | 按类型读,字符串再按两种格式解析 |
数量列出现 1,200 |
千分位被当成文本 | 去分隔符后转数字,转不了进错误行 |
| 同一个商品出现两次 | 文件里重复,或上次导过 | 文件哈希拦重复,业务键拦行内重复 |
| 导入到一半卡住 | 一次性读进内存,或逐行提交 | 流式读,批量提交,进度落库 |
| 客户说“我表里明明有这一行” | 隐藏行、筛选状态,或标题行数对不上 | 确认 headRowNumber 和 sheetIndex,别让示例行把首条数据吃掉 |
| 合并单元格里的值只有第一行有 | 纵向合并区域第二行起该列是 null | extraRead 收合并区间回填,或模板校验阶段拒收纵向合并 |
导出要先想清楚谁在等
导出分两种。一种是小报表,几千行,点一下等两秒,浏览器直接下载;另一种是几万、几十万行,或者要跑复杂查询,必须异步。分界线看用户愿意等多久:超过十秒就该进下载中心——这是我的经验线,硬一点的理由是网关超时和同步导出占着容器线程,客户连点两次,两个线程就没了。同步导出不要用 XSSFWorkbook 把整个表建在内存里。用 SXSSFWorkbook,设置一个几百行的窗口,写满就刷到临时文件,内存占用和行数无关。
try (SXSSFWorkbook wb = new SXSSFWorkbook(500);
     OutputStream out = response.getOutputStream()) {
    Sheet sheet = wb.createSheet("销售明细");
    Row head = sheet.createRow(0);
    head.createCell(0).setCellValue("单号");
    head.createCell(1).setCellValue("金额");
    head.createCell(2).setCellValue("下单时间");

    CellStyle moneyStyle = wb.createCellStyle();   // 样式放循环外建,逐格建会撞 POI 64000 上限
    moneyStyle.setDataFormat(wb.createDataFormat().getFormat("0.00"));
    int r = 1;
    for (OrderRow o : queryInPages(tenantId, userId)) {
        Row row = sheet.createRow(r++);
        row.createCell(0).setCellValue(o.orderNo());
        Cell amount = row.createCell(1);
        amount.setCellValue(o.amountCent() / 100.0);
        amount.setCellStyle(moneyStyle);
        row.createCell(2).setCellValue(o.createdAt().format(DATE_TIME));
    }
    wb.write(out);
    wb.dispose();
}
写响应前把头设齐:Content-Type 用 xlsx 的 MIME,Content-Disposition: attachment; filename*=UTF-8''…,中文文件名要 filename* 编码,不然浏览器拿到的不是“直接下载”。流式写响应后中途抛错,200 已经提交,客户拿到的是损坏文件——同步小导出先落临时文件,写完再 stream,失败时状态码还来得及改。
金额写成数值并设两位小数格式,不要写成带“¥”的字符串,否则客户没法求和。单号、手机号、身份证号这类长数字要设成文本格式,不然 Excel 会显示成科学计数法,或者把前导零吞掉。日期统一成 yyyy-mm-dd hh:mm:ss 的日期单元格——文本日期没法筛选排序透视,和金额要能求和是同一条逻辑,别让客户那边因为区域设置变成 03/01/2024。
几十万行的导出不要靠 LIMIT offset 翻页,越往后扫得越慢,最后几页能把数据库拖住。按主键游标往下取,每页一千条,内存和耗时都稳;中途失败能重试(从头跑),要断点续传就在任务表加一列 cursor,每页写回当前最大主键,重试从它继续。
导出必须走和列表一样的数据权限。01 和 02 那两篇里都提过,导出是最容易漏权限的入口:列表加了 tenant_id 条件,导出另写了一条 SQL,条件没带,一次就把全库拉走了。导出 SQL 最好复用列表的查询构造器,不要另起一段。异步导出要有一张任务表,记录谁、导什么、范围、状态、文件路径、过期时间。用户在下载中心看到进度,失败能重试,文件过期自动清。
CREATE TABLE export_task (
  id           BIGINT PRIMARY KEY AUTO_INCREMENT,
  tenant_id    BIGINT NOT NULL,
  user_id      BIGINT NOT NULL,
  export_type  VARCHAR(64) NOT NULL,
  params_json  JSON NOT NULL,
  status       VARCHAR(16) NOT NULL DEFAULT 'QUEUED',
  file_path    VARCHAR(500) NULL,
  row_count    INT NULL,
  error_msg    VARCHAR(500) NULL,
  expire_at    DATETIME NULL,
  created_at   DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  KEY idx_user_status (tenant_id, user_id, status)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
公式注入要分文件类型说。POI 写 xlsx 的字符串单元格本身不会执行公式,管住自己别用 setCellFormula 拼用户输入就行;真正会跑的是 CSV——Excel 打开 CSV 时把 =、+、-、@ 开头的格子当公式执行,而且加引号前要先判数字:拿 new BigDecimal(v) 试一下,是数字不加(退款负数行加了引号会变文本,求和直接漏数),不是数字且开头命中这几个字符才加。这个入口不挡,导出的文件本身就是攻击面。
导出的文件不一定在 Excel 里打开。WPS、Numbers、在线表格对公式和格式的支持不一样,最稳的是只写值、不写公式,列宽设一个够用的固定值。客户拿到文件第一眼是看列宽和表头,不是看你的 SQL 写得多漂亮。
打印是另一套系统
浏览器打印和“打印出来能用”之间,差着一台真实的打印机。A4 套打要处理纸张、边距、缩放、页眉页脚。@page 能设纸张大小和页边距,但浏览器自带的页眉页脚、缩放比例,代码控制不了,得让用户在打印对话框里关掉。Chrome 的 kiosk 模式可以跳过对话框,但部署和升级又是另一回事。说到底,打印是物理问题。
@page {
  size: A4 portrait;
  margin: 12mm 10mm 14mm 10mm;
}
.sheet {
  page-break-after: always;
  font-family: "SimSun", "Microsoft YaHei", sans-serif;
}
.sheet:last-child { page-break-after: auto; }
小票打印机是另一条路。58mm 和 80mm 的热敏机走 ESC/POS,浏览器打印经常对不齐,最好用本地打印控件或者服务端生成 PDF 再调系统打印。针式打印机打多联单据,要按实际纸张调偏移,不同品牌差一两个毫米很常见;调的时候用客户那台机器,不要用办公室的激光打印机试。
服务端生成 PDF 还要看字体。Linux 服务器默认没装中文字体,本地测试好好的,部署上去全是方块;镜像里要带字体文件,或者把字体打进应用。打印机型号要在合同里写清楚。同一个系统,换一台机器,边距、字体、切纸命令都可能不一样;有的机器不支持中文二维码,有的驱动只认特定纸张。交付前问一句“仓库那台是什么型号”,比到现场再装驱动省一天。
| 打印场景 | 常见介质 | 容易出问题的地方 |
|---|---|---|
| 拣货单、出库单 | A4 或 A5 套打 | 边距偏移、分页把合计行切走 |
| 收银小票 | 58mm / 80mm 热敏 | 字符宽度、切纸、二维码太小扫不出 |
| 多联单据 | 针式打印机 | 复写位置、纸张厚度、连续纸走纸 |
| 标签 | 热敏标签机 | 条码密度、留白不够、打印速度太快 |
打印模板放到外面
客户一定会改模板,交付后每个月都会来一次。加一个 logo、换一个字段、把“客户名称”改成“购货单位”,模板写死在代码里,改一次发一次版。
选型落点:服务端 PDF 用 FreeMarker 出 HTML,openhtmltopdf 转 PDF;套打是底图 PDF 加数据层绝对坐标覆盖,两套坐标分开,别混。模板入库 print_template(code, version, content, is_active),用字段占位符,客户自己能改,至少不用为一行字重新部署;「改坏了能回退」就是把 is_active 指回旧版本,不需要文件系统操作。
字段名对不上时能提示,不要让客户对着 ${order.amount} 猜。模板到后来都是客户自己在改,选型按这个前提来。
文件、权限和清理
导入的原始文件、导出的结果文件、打印的 PDF,都存在磁盘上。谁能下载、存多久、占多少空间,这三件事要一起定。下载链接不能直接暴露文件路径。用任务 id 加当前用户校验,或者生成一个短时效的签名 URL;PDF 和 Excel 里可能有客户的全量数据,一个可猜测的路径就是一次泄露。文件目录按租户分,清理任务按 expire_at 删,别让两年前的导出文件一直躺在盘里。这些文件也是数据。
文件要有备份,也要有生命周期。导出文件丢了可以重导,导入的原始文件丢了就再也拿不回来;原始文件至少留到项目验收后半年。磁盘空间要监控,别等客户说“上传失败”才发现满了。客户那边的 IT 会问文件存在哪台机器上、换了服务器还在不在、要不要跟数据库一起备份、能不能只允许内网下载,这些问题验收会上总要回答一遍。导出和打印都要留日志(打印是一张 print_log:谁、什么时候、哪张模板、哪张单、几份),导出记谁、什么时候、哪个报表、多少行。客户内部审计问起来,这些日志就是证据;自己排查“为什么这个用户能看到别人的数据”时,也是第一手材料。
交付前自己先走一遍
验收前一天,我会拿客户给的原始 Excel 和仓库那台打印机,自己先走一遍。是他们真实在用的那份,带合并单元格、带隐藏列、带几个重名的商品。导入看错误文件能不能指导修改,导出看客户打开后能不能直接求和,打印看边距和分页。都过了以后,验收当天就少一半争论。
这些活没有技术难度,只有工作量。报价时单列出来,客户知道钱花在哪,你也不用拿周末补。要不要立项看客户的量:一个月导两次、打十张单,顺手做掉;每天几百份 Excel、几十台打印机,就得按模块排期。
系列:上一篇 RAG 知识库实战:检索不准,问题多半不在大模型 | 下一篇 线上线下一套库存 | 相关 数据迁移完了,没人敢关旧系统