数据迁移完了,没人敢关旧系统
现在接迁移项目,报价单上我会先加两行:旧数据导出原件由客户负责提供并签字确认版本,口径对照表由双方财务在开工前逐科目确认。这两行,是那次 12,788 的差额换来的。
迁移项目开工那天,客户发来一个压缩包,说数据都在里面。解压出来十几个 Excel,文件名是“客户(1).xlsx”“客户-最终.xlsx”“客户-最终-改.xlsx”,最后那个的修改时间比前两个还早。
导入脚本写了一个下午就跑通了,两千多条客户、一万多条商品,控制台一行红字都没有。第二个星期财务打电话过来,问上个月的应收为什么少了一万二千七百八十八。再去翻那几个 Excel,才发现有一列的金额带着千分位,脚本按字符串截断,12,800.00 被读成了 12,差额正好是 12,788。
脚本没有报错,因为错的不是脚本——这类项目里,写导入代码是最不难的一段。难的是导完之后,客户拿旧系统的报表来对新系统,一行一行问差额去哪了。
“迁完”这两个字,得由财务来定义
技术这边说迁完,指的是脚本退出码是 0、表里有数据。客户那边说迁完,看的是另一套东西:应收、已收、未收和旧系统一致,客户数、商品数、库存件数、未结订单数对得上,每个岗位登录进来看到的东西和以前一样。
这里每一类对不上,坏的地方都不一样。金额差,两次迁移里大头都是口径和舍入,比如旧系统含税、新系统拆了税额,或者一笔收款被拆到两个客户头上。总量差,多半是行被漏读或者重复读,合并单元格和隐藏行都在这类。权限不对,导入脚本一切正常,是组织树和角色映射没做对,人登录进来看到的是别人的门店。
口径的例子随手就有。旧系统把一笔一万元的订单记成应收一万,新系统按未税 8,849.56 加税 1,150.44 拆开,客户拿两张报表一比,差一千一百多,第一反应是钱少了。两边都没算错,是记账的位置不同。
先把旧系统的写入停掉,或者至少记下一个明确的截止时间点。很多迁移项目对不上账,原因不在脚本,在旧系统还在往里录单,核对的两个人手上拿的不是同一个时刻的数据。截止时间点要写进迁移方案,精确到分钟,客户业务负责人在上面签字。
口径也得先摊开。旧系统里的“应收”可能包含未发货的订单,新系统的应收只认已发货;旧系统按含税金额记账,新系统把税额单独拆出来。这些差异两边都没算错,是两套账的定义不同。迁移前拉一张对照表,把每个科目在两边分别怎么算写清楚,财务确认之后再动手,比事后解释三十笔差额便宜得多。
原始行先落库,别边读边写业务表
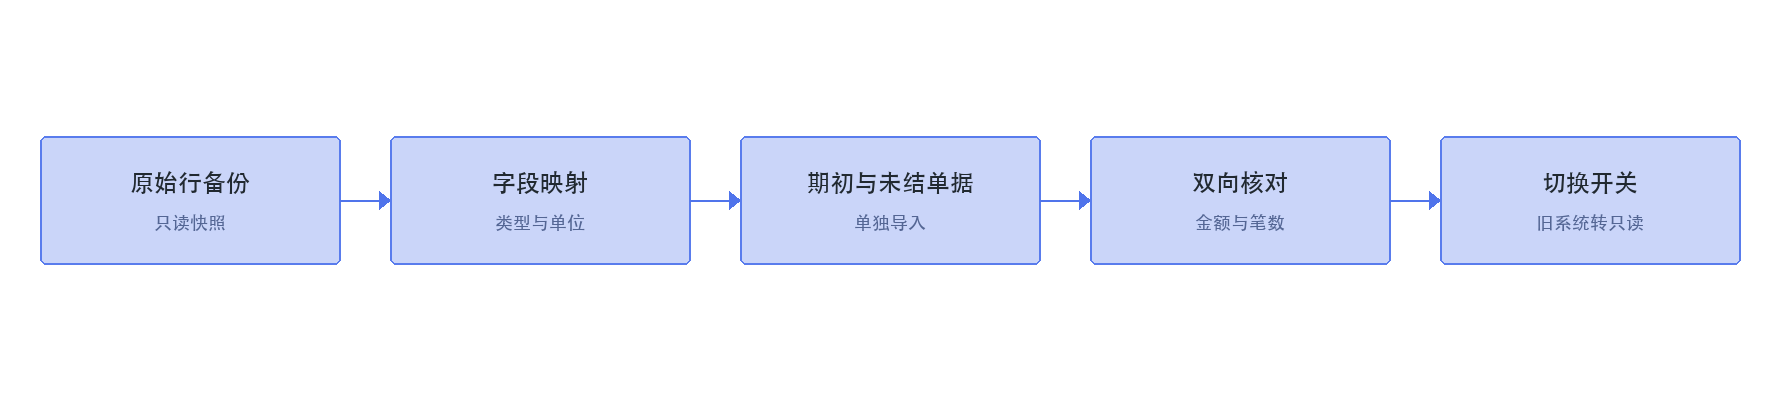
我现在的做法是先建一组 mig_ 开头的表,把 Excel 或旧库导出的每一行原样存下来,再写脚本从原始行往业务表搬。原始行里有批次号、工作表名、行号、原始 JSON,出错时能直接定位到“客户(1).xlsx 的第 47 行”。
CREATE TABLE mig_batch (
  id            BIGINT PRIMARY KEY AUTO_INCREMENT,
  batch_no      VARCHAR(32) NOT NULL,
  source_name   VARCHAR(200) NOT NULL,
  cutoff_at     DATETIME NOT NULL,
  status        VARCHAR(16) NOT NULL DEFAULT 'STAGED',  -- STAGED / LOADING / LOADED / FAILED
  created_at    DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  UNIQUE KEY uk_batch (batch_no)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

CREATE TABLE mig_raw_row (
  id            BIGINT PRIMARY KEY AUTO_INCREMENT,
  batch_no      VARCHAR(32) NOT NULL,
  sheet_name    VARCHAR(64) NOT NULL,
  row_no        INT NOT NULL,
  raw_json      JSON NOT NULL,
  import_status VARCHAR(16) NOT NULL DEFAULT 'NEW',  -- NEW / OK / ERROR / REJECTED,拒迁行写 REJECTED、原因进 error_msg
  error_msg     VARCHAR(500) NULL,
  UNIQUE KEY uk_row (batch_no, sheet_name, row_no),
  KEY idx_batch_status (batch_no, import_status)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
有了这张表,重跑就是先 DELETE FROM mig_raw_row WHERE batch_no = ?,再重新灌一遍,业务表按业务键做覆盖。覆盖键每类实体写死一个:客户用旧客户编码、商品用 SKU 编码,对不上编码的先走别名映射,别拿名称覆盖——两个没确认过的别名,重跑一遍就合并成一条了。迁移报告里输出「覆盖 N 行、新插 M 行」,和上一遍对不上就停。覆盖还有一面很少被提:它会把试运行期间客户手工改过的行悄悄滚回旧值,所以覆盖前对将被覆盖的行做一次 diff,手工改过的字段列出来人工确认。不要直接 TRUNCATE 清空业务表,客户可能在试运行期间已经手工补了几条数据,清空之后这些记录就没了。
Excel 读出来的东西和眼睛看到的不一样,下面这张表里的每一行都真实发生过:
| 屏幕上的样子 | 解析出来是什么 | 处理方式 |
|---|---|---|
| 合并单元格里的客户名 | 只有第一行有值,下面几行是空 | 按行号向下填充,填充前先确认这一列确实是分组列 |
金额 12,800.00 |
字符串,转数字时被截成 12 | 去掉千分位和货币符号再转 BigDecimal,转完核对量级 |
日期 2024/3/1 与 2024-03-01 混用 |
一半是日期,一半是字符串 | 统一按单元格类型读,字符串按两种格式显式解析,解析失败进错误表 |
身份证号 012345... |
前导零丢了,或者变成科学计数法 | 按文本读,不要经过数值类型;导出模板里这一列预设为文本格式 |
| 合计行混在明细中间 | 被当成一条客户记录导进去 | 识别“合计”“小计”并跳过,跳过数记进迁移报告 |
| 同一客户三个写法 | 建出三个客户,应收被拆散 | 先做别名映射表,候选列出来人工确认,不要用相似度自动合并 |
| 隐藏行、空行、批注 | 有的读得到,有的读不到 | 约定解析库对隐藏行的行为,显式跳过并记数进报告;空行跳过计数;批注抽进 raw_json |
金额那条值得单独说。Java 里用 double 接 Excel 的数字,19.99 在内存里就是 19.989999…,这个尾巴进了浮点列、或者先乘数量再取整,就变成几毛钱的差;DECIMAL(10,2) 列本身会把 19.9899 收敛回 19.99,事故点在列类型和运算顺序,别把账记在 DECIMAL 头上。统一走字符串到 BigDecimal,最后一步再定小数位,入库按分存成整数。
static long toCent(String raw) {
    if (raw == null || raw.isBlank())
        throw new IllegalArgumentException("金额列为空");   // 空和零是两件事:空进错误表,零只能来自写了 0 的格子
    String s = raw.replaceAll("[\\s\\u00A0,,¥¥]", "");   // 全角逗号和不间断空格在 Excel 导出里常见,trim 去不掉 U+00A0
    boolean negative = s.startsWith("(") && s.endsWith(")");
    if (negative) s = s.substring(1, s.length() - 1);
    BigDecimal v = new BigDecimal(s).setScale(2, RoundingMode.HALF_UP);
    return (negative ? v.negate() : v).movePointRight(2).longValueExact();
}
longValueExact() 会在溢出时抛异常,这比悄悄截断好。HALF_UP 是不是对,要看财务的口径,有的场景要求银行家舍入;isBlank() 是 Java 11 的方法,还在 Java 8 的现场换成 trim().isEmpty()。问一句比猜一次省事。
空白格尤其要抛,不能返回 0。列错位之后整列金额读空,返回 0 就是全表应收无声归零,比开头那个 12,788 可怕得多——那个至少财务能发现。空单元格走错误表,0 只能来自显式写了 0 的格子;每个批次装载完先数一遍金额列为空的原始行数,大于零就整批停下来人工看。
期初余额加未结单据,不重放三年流水
旧系统里三年的流水一笔一笔导进新系统,看起来最完整,实际最容易把账做坏。历史单据的状态、价格、优惠、退货关系只要有一处映射错,新系统的应收就会跟着错,而且错在三年里的某一天,查起来像大海捞针。
我一般只迁两类东西:截止时点的期初余额,和还没结完的单据。已完结的历史单据导一张归档表,字段按查询需要裁,不进业务表,客户要查旧单时走归档查询。这样新系统的账从切换那天开始长。起点是清楚的。
期初余额包括应收、应付、预收、预付、库存金额,按客户、供应商、仓库、科目分别落,一个主体一个科目一行:
CREATE TABLE mig_opening_balance (
  source_system VARCHAR(32) NOT NULL,
  subject       VARCHAR(16) NOT NULL,   -- AR 应收 / AP 应付 / ADV_RC 预收 / ADV_PA 预付 / INV 库存金额
  party_type    VARCHAR(16) NOT NULL,   -- customer / supplier / warehouse
  party_id      BIGINT      NOT NULL,
  cent          BIGINT      NOT NULL,   -- 截止时点余额,分;一律存自然方向的正数,方向靠 subject 区分
  as_of         DATETIME    NOT NULL,   -- 截止时点,精确到分钟,和冻结时点同一个钟
  PRIMARY KEY (source_system, subject, party_type, party_id)
);
库存数量要和金额一起迁,只迁数量的话,成本核算会从第一天就是错的。未结单据要保留旧单号。新系统另生成一个内部单号没问题,但 source_system + old_order_no 上要有唯一键,客户拿旧单号来查时能查到,重复导入时也能靠这个键挡住。前提要写明:旧单号在一个来源里全局唯一,旧系统销售单和退货单分开编号的话,键里要再加单据类型;装载时空单号统一转 NULL——Excel 导出来的空格子常是空串,空串会撞唯一键,NULL 不会。
ALTER TABLE biz_order
  ADD COLUMN source_system VARCHAR(32) NOT NULL DEFAULT 'NEW',
  ADD COLUMN old_order_no VARCHAR(64) NULL,
  ADD UNIQUE KEY uk_source_old_no (source_system, old_order_no);
old_order_no 允许 NULL 是故意的:新系统自己开的单没有旧单号,几条 NULL 并存才正常。这里用的是 MySQL 唯一索引不约束 NULL 那个特性,别把它当成约束失效,那正是它要的效果。
旧状态到新状态的映射要单独一张表,不要写在 CASE WHEN 里。上次那套旧系统三十个状态,新系统八个,比例各家不同,但映射关系里一定有“暂时不知道该归到哪”的,这类让 new_status 留空,就是待确认清单,列出来让业务确认,别顺手映射成“已完成”。
CREATE TABLE mig_status_map (
  source_system  VARCHAR(32) NOT NULL,
  old_status     VARCHAR(32) NOT NULL,
  new_status     VARCHAR(32) NULL,        -- 留空 = 待业务确认;映射器遇到空值拒迁该单并计数
  confirmed_by   VARCHAR(64) NULL,
  confirmed_at   DATETIME NULL,
  PRIMARY KEY (source_system, old_status)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO mig_status_map (source_system, old_status, new_status)
VALUES ('LEGACY', '3', 'PAID'), ('LEGACY', '4', 'SHIPPED');
-- 没有把握的先留空,new_status 为空的行就是待确认清单
已填 new_status 却没填 confirmed_by 的行,不应该出现在生产库——new_status 留空的待确认行是设计的一部分,要拦的是那些拍脑袋填了状态却没人签字的。这条比映射本身重要,出了争议,能指着它说这个状态是谁确认的。这条要有执行者才算数:装载脚本启动前跑一句 select count(*) from mig_status_map where new_status is not null and confirmed_by is null,大于零就拒跑并打印清单——上面那个 INSERT 示例自己就没填确认人,照抄进生产没有任何东西拦它。
时间字段也要单独处理。旧系统只给一个 2024-03-01 00:00:00 的字符串,它到底是本地时间还是 UTC,要看旧系统的部署和数据库配置,不能假设。落库时保留原值,另存一个明确转换后的时间,两条都留着,日后对不上还能回查。
主数据的顺序反了,后面全要返工
迁移顺序我固定成:组织、门店、仓库、员工,然后客户、供应商、商品、价格,接着期初库存和期初余额,再是未结单据,最后才是账号、角色和数据范围。员工要先于单据,因为单据的创建人、业务员、审批人都要指向一个人。已经离职的员工不能删,员工表加一列 status,离职置 DISABLED,装载脚本禁止 DELETE 这张表;历史单据上的创建人列指向这个人——人还在,只是登录不进来。删掉之后,审计问“这单是谁开的”就只能回答“查不到了”。这个顺序反了,迁完也得推倒重来。
客户和商品的主数据,字段多还算小事,真正麻烦的是同一个东西有多个名字。同一家客户在三个 Excel 里叫“杭州某某贸易”“杭州某某贸易有限公司”“某某贸易”,靠模糊匹配自动合并,迟早把两家不相干的公司并成一家。做法是先把旧名称全部列出来,按名称、电话、税号给出候选分组,人工确认,确认结果写进 mig_alias。
CREATE TABLE mig_alias (
  id            BIGINT PRIMARY KEY AUTO_INCREMENT,
  source_system VARCHAR(32) NOT NULL,
  entity_type   VARCHAR(16) NOT NULL,   -- CUSTOMER / PRODUCT
  old_name      VARCHAR(200) NOT NULL,
  old_code      VARCHAR(64)  NULL,      -- 编码映射走这列,名称映射走 old_name,各自对应唯一键的一半
  target_id     BIGINT NOT NULL,
  confirmed_by  VARCHAR(64) NOT NULL,
  UNIQUE KEY uk_entity_old (source_system, entity_type, old_name)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
商品这边,SKU 编码冲突、规格拆分、单位换算是三个高频问题。旧系统一个“可乐”带着箱和瓶两个单位,新系统按基本单位建 SKU,换算率要有落点:biz_product_uom(product_id, uom_code, ratio, is_base) 一张小表,期初库存一律折基本单位入库,除不尽的余数进差异表;条码重复的要单独列出来,仓库扫错码比录错单更难发现。
权限放在最后迁,但验收要最先做。找五个真实岗位的账号,登录之后拿列表条数和金额合计跟旧系统对,不是看“能不能打开页面”。老板、财务、区域经理、店长、店员这五类覆盖到了——两次迁移里权限类问题最后都出在这五类;有总部职能岗(采购、仓管)的客户按需追加。
核对要能回答“差在哪一行”
跑 COUNT(*) 对比两边行数,只能说明记录的条数接近,条数接近和钱对上是两回事。
核对先从总量对起:客户数、商品数、未结单据数、库存件数。然后按客户、科目、仓库把金额逐项汇总比。最后是业务不变量,那种无论怎么迁都必须成立的等式,比如每张未结订单的已收金额不超过应收金额——这条有前提:旧系统不允许超收挂预收,允许的话它会把合法数据刷进差异表,超收单要单列成规则冲突一类。库存等式(期初加出入库等于当前库存)要等切换后跑完第一个周期才验得出来,演练期验的是「期初逐仓加总等于旧盘点表」这种当场能对的数。
这条等式签字前先回答一个问题:验的是哪一种相等。mig_opening_balance 的 AR 是财务口径的截止日应收,biz_order 里是未结单据的应收,两者相等的前提是「已完结但未收清」的钱不存在,或者已经单独迁成了单据——前提不成立,这条 SQL 家家红;期初表要是本来就从未结单据汇总出来的,它就是自己验自己,全绿但什么都没证明。
两侧各自先按客户聚合再拼;inner join 会把「整户没迁」「期初漏导」这类最危险的差异直接吃掉,所以缺的一侧要按 0 补,让缺户以非零差额自己跳出来:
WITH new_side AS (
  SELECT customer_id, SUM(receivable_cent) AS cent
    FROM biz_order
   WHERE source_system = 'LEGACY'
     AND status NOT IN ('COMPLETED', 'CANCELLED', 'REFUNDED')
   GROUP BY customer_id),
old_side AS (
  SELECT party_id AS customer_id, cent
    FROM mig_opening_balance
   WHERE subject = 'AR' AND party_type = 'customer')
SELECT k.customer_id,
       COALESCE(n.cent, 0) AS new_ar,
       COALESCE(o.cent, 0) AS old_ar
  FROM (SELECT customer_id FROM new_side
        UNION
        SELECT customer_id FROM old_side) k
  LEFT JOIN new_side n ON n.customer_id = k.customer_id
  LEFT JOIN old_side o ON o.customer_id = k.customer_id
 WHERE COALESCE(n.cent, 0) <> COALESCE(o.cent, 0);
status NOT IN 后面那三个值别 hardcode 在查询里。新系统八个状态里哪些算结清,进一张字典表 biz_status(status, is_terminal),查询改成 status IN (SELECT status FROM biz_status WHERE is_terminal = 1);漏掉一个终态,未结集合里就混进已结单,整条对账口径跟着错。
容差写 0。舍入造成的分币差异单独放一张表,列出来让财务决定是调账还是接受,不要用一个 abs(diff) <= 100(一元以内全收)把整类问题盖掉。差异表要有责任人、处理状态和处理备注,它是一张工作单,不是一个日志:
CREATE TABLE mig_diff (
  id          BIGINT PRIMARY KEY AUTO_INCREMENT,
  check_item  VARCHAR(32) NOT NULL,   -- AR_BALANCE / RECEIVED / STOCK / OPEN_ORDER / SCOPE
  subject     VARCHAR(64) NOT NULL,   -- 客户 / 供应商 / 仓库 / 岗位
  old_cent    BIGINT      NULL,
  new_cent    BIGINT      NULL,
  diff_cent   BIGINT      NOT NULL,
  owner       VARCHAR(32) NOT NULL,   -- 责任人落人名
  status      VARCHAR(16) NOT NULL DEFAULT 'OPEN',  -- OPEN / ADJUSTED / ACCEPTED / CLOSED
  accepted_by VARCHAR(32)     NULL,   -- 客户书面接受:ACCEPTED 必须带这两列
  accepted_at DATETIME        NULL,
  note        VARCHAR(500)    NULL,
  UNIQUE KEY uk_item (check_item, subject)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
| 核对项 | 旧系统取数 | 新系统校验 | 容差 |
|---|---|---|---|
| 应收余额 | 财务应收报表截止日 | 按客户汇总 receivable_cent |
0,分币差异单列 |
| 已收金额 | 收款单合计 | 收款流水按客户汇总 | 0 |
| 应付余额 | 财务应付报表截止日 | 按供应商汇总期初 AP | 0,分币差异单列 |
| 预收、预付 | 旧系统预收预付明细 | 期初表 ADV_RC/ADV_PA 逐户加总 | 0 |
| 库存金额 | 期末盘点金额 | 期初表 INV 逐仓加总 | 0,与库存件数同过 |
| 库存数量 | 仓库盘点表 | 期初加出入库流水重算 | 0,负库存单列 |
| 未结订单 | 旧系统状态报表 | 新系统非终态订单 | 0,状态待确认单列 |
| 可见范围 | 五个岗位的实际列表 | 同岗位登录后的条数与金额 | 条数一致,金额一致 |
口径对照表是另一份东西,管科目怎么映射,不管数。长这样:
| 旧科目 | 新科目 | 映射口径 |
|---|---|---|
| 应收账款(按往来户挂明细) | 应收账款(客户辅助核算) | 逐户对平,坏账准备单列一行跟着走 |
| 预收账款贷方余额 | 合同负债/应收账款贷方 | 方向不变,已履约部分迁移前先冲完 |
| 待摊费用 | 预付账款 | 按受益期重算,摊余对不上就调期初 |
每一行都要双方财务签字。核对表签的是数,这张表签的是口径——两份签完,旧数才能进新账。
差异清零或者客户书面接受之后,才进切换。财务在迁移报告上签字的那一页,比技术这边的任何测试报告都管用。签的是数,不是流程。
切换、增量和回滚,都要在演练里跑一遍
正式切换前至少全量演练两遍。第一遍把能发现的错都暴露出来,第二遍的重点是差异为零,两遍之间改的是脚本和映射,不是手工补数据。手工补的数据不会出现在下一次演练里,切换当天会原样变成新的差异。回滚也要在演练里过一遍,验的是切回去之后数据基线怎么重置、能不能当第二次切换的起点。
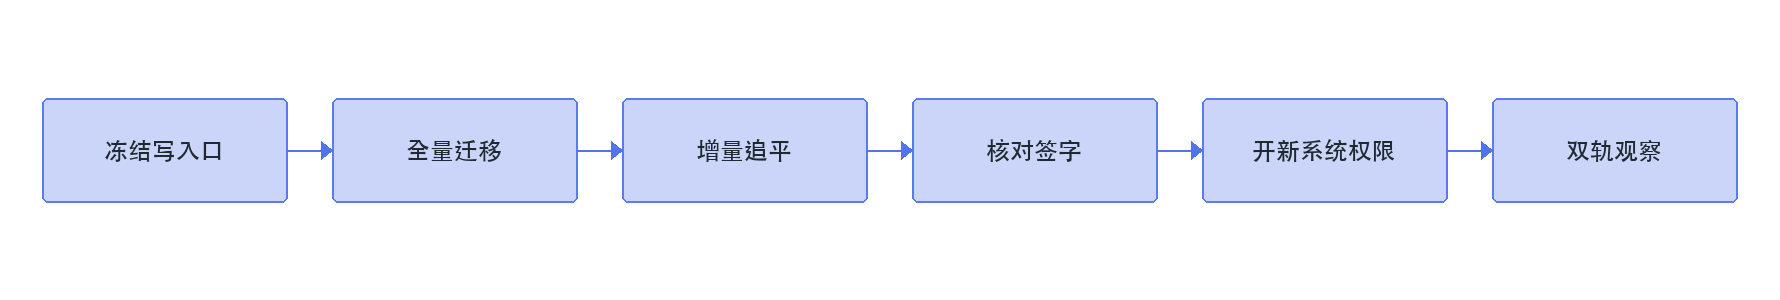
演练时把整个流程计时。客户能接受的停机窗口通常是半夜几个小时,导入、核对、权限验证、冒烟测试都要塞在里面,时间不够就提前砍范围,别指望当天加速。切换当天先冻结旧系统的写入口(停录单、停对外接口,动的是服务,不是数据库权限),记下时间点 T1,做一次全量备份并记下 binlog 位点,位点只留作审计和补增量的锚,正常流程不回放它。全量导完之后,T1 前最后一次同步到 T1 之间还有几分钟的单,按 updated_at 抽一次,窗口往前重叠十分钟,靠唯一键去重。
SELECT *
FROM legacy_order
WHERE updated_at >= :last_sync_at - INTERVAL 10 MINUTE
  AND updated_at <  :cutoff_at;
这条增量押在旧系统有可靠的 updated_at 上,演练时先验一遍:抽几单昨天确实改过的,看时间戳真变了没有——老系统直连改库、批量作业不刷时间戳是常态。硬删除的行永远进不了增量,靠每日兜底:拿旧系统的全量单号集合对新系统反查一次「有他无我」,差集进差异表。
回滚方案要具体到动作:旧系统保持只读但可登录,新系统切换前的数据库快照留着,入口域名指向哪一台、切回来要改哪个配置,写在一页纸上。数据库的降级脚本通常写不出来,真实可行的回滚是新库回到快照、入口切回旧系统,所以快照和旧系统的可登录状态比“反向 SQL”可靠。回滚只承诺一个窗口:双轨开始后二十四小时内,丢的是不到一天的录单,按每天收盘后导出的留底在旧系统补录,责任人写在这一页纸上;过了这个窗口不再回滚,出错走数据修复。所以双轨期每天收盘后,要把新系统当天的单据和收款流水导出一份留底——回滚的底气是这份清单,不是快照的新鲜程度。这一页纸,比脚本值钱。
切换后跑一周双轨,旧系统只读,新系统正常录单。旧系统只读就没有「当天的收款」可比:比的是新系统收款流水对支付渠道和银行流水、订单数对冻结时点基线加当天新增;财务月结、退款这类流程要是还要回旧系统走,那就是选择性双写,哪边为准、谁修、修完谁复核要先写死。一周没差异、并且新系统完整跑过一期应收报表和冻结时点接得上,旧系统再下线——下线拆成停登录和归档移交两步,别一次删干净。双轨窗口要能盖住一次完整月结,切换日就别挑在月底最后一天;窗口盖不住月结,就把双轨拉到月结走完,别为了赶下线时间省这一步。
关旧系统的那三天
演练第二遍跑完是周四晚上,差异表还剩十一行,八行是客户别名没确认,三行是旧系统里两笔跨月退货的状态映射。周五上午客户业务的人在会议室里把这十一行逐条定了,下午重跑,差异为零。
切换放在周日凌晨。全量导入四十分钟,增量两分钟,核对脚本跑了七分钟,五个岗位的账号逐个登录看了一遍。早上六点,财务在迁移报告的最后一页签了字,我们才把旧系统数据库的写入权限也收掉。那页纸现在还在项目的验收附件里,上面只有一行手写的“数对”,加一个日期。
系列:上一篇 私有化部署的最小交付包,拔掉网线还能装起来才算 | 下一篇 线上出问题,先分清是所有人都慢还是一个人慢 | 相关 主流程演示得再顺,客户还是要先导一个 Excel