文件上传:直传、断点续传、秒传各解决什么
客户要把一段 800MB 的施工过程视频传进系统。第一版做法是前端把文件 POST 给应用服务器,服务器收完转存到 OSS。上线第一个月就撞了三件事:Nginx 报 413,把 client_max_body_size 调到 1G;应用服务器内存涨了 2G,收发全走一遍缓冲区,遇到并发就内存耗尽(OOM);调大内存之后,客户网络到下午不稳定,传到 95% 断了,刷新页面从头再来。
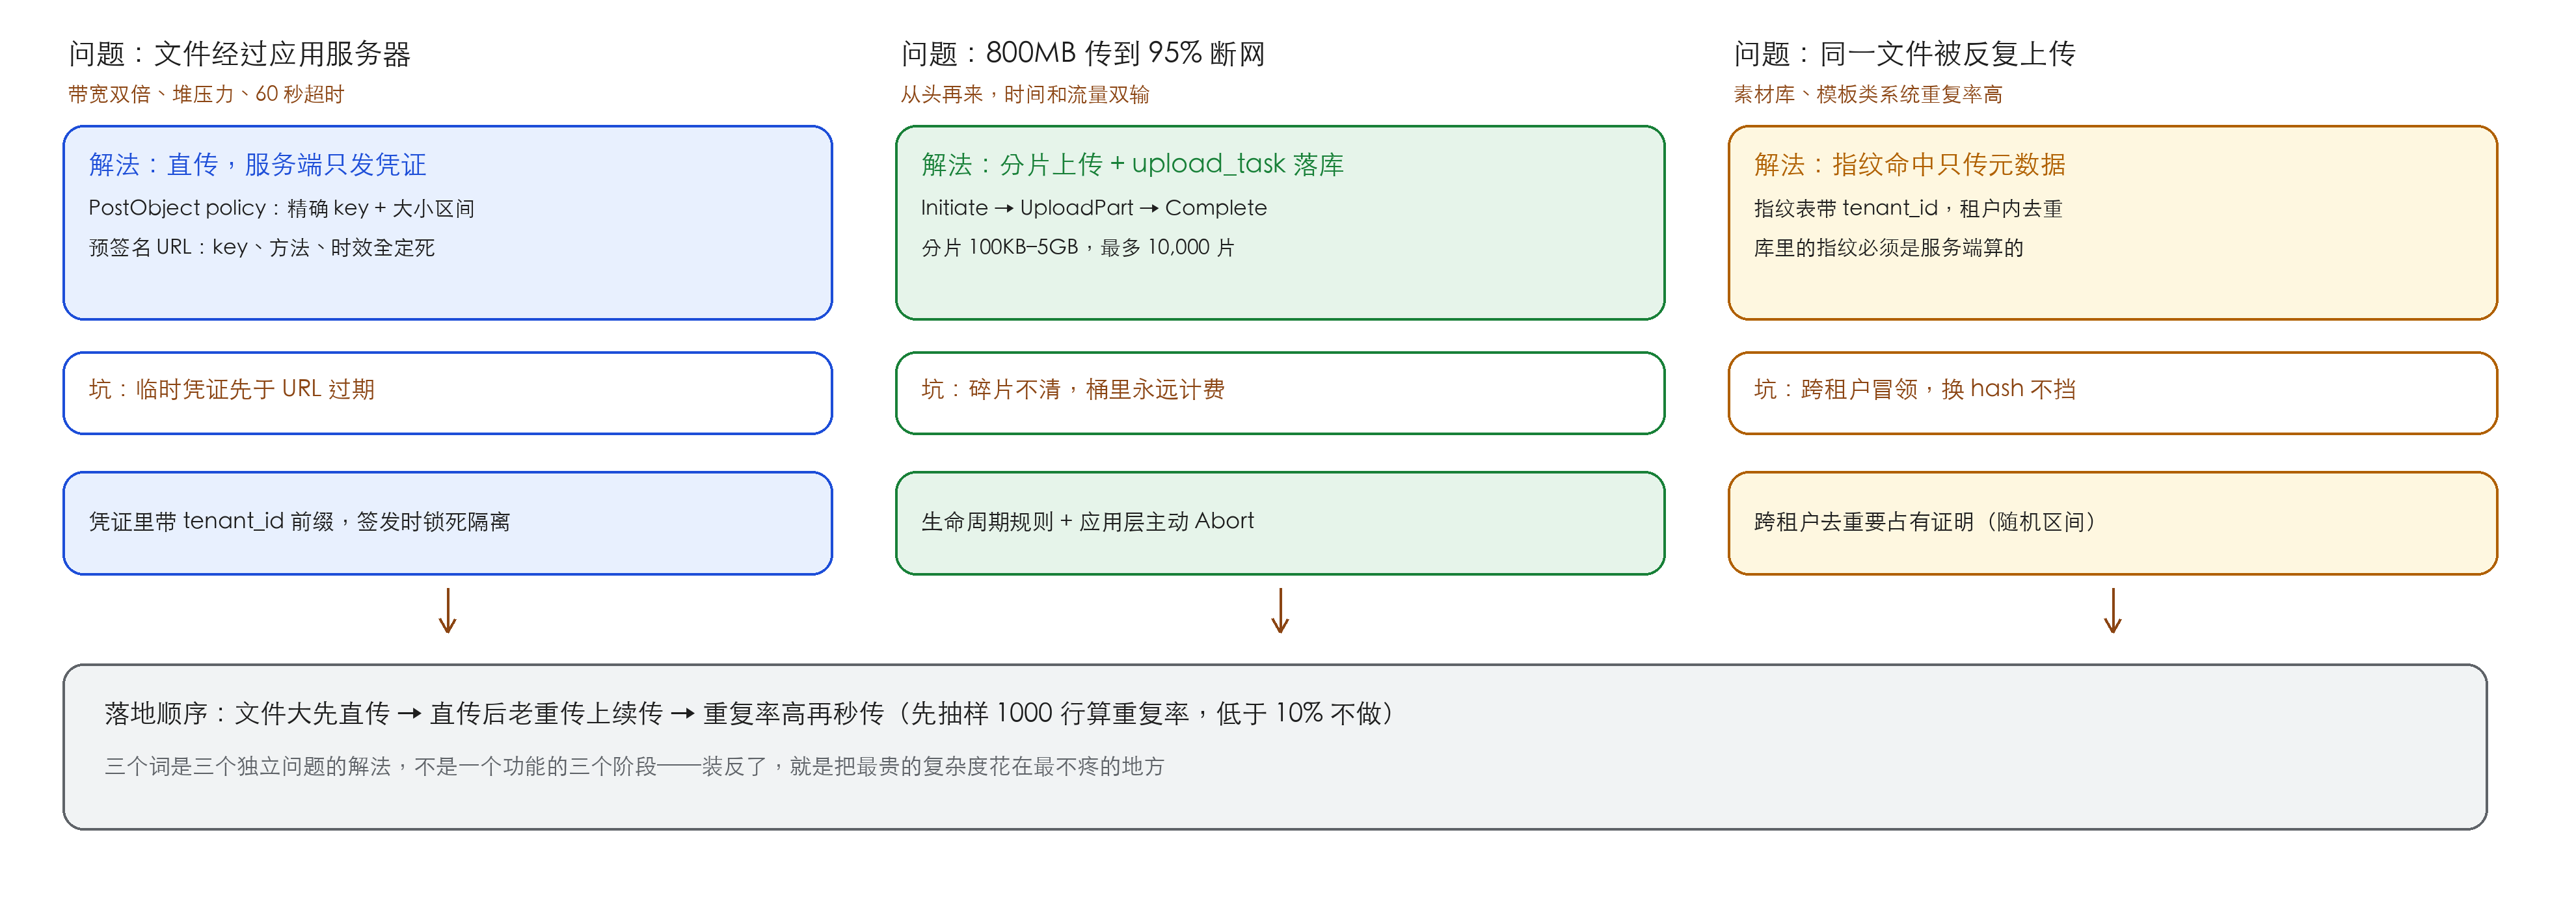
这三个症状对应三个词:直传、断点续传、秒传。多数人第一次接触会把它们当成一个功能的三个阶段——先做直传,再加续传,最后上秒传。这个顺序感是错的。三个词解决的是三个独立的问题:直传解决「文件不该经过你的服务器」,断点续传解决「大文件失败不该从头来」,秒传解决「重复的文件不该传第二遍」。一个问题一种解法,装反了解决不了。
这篇把三个问题分开讲:各自的机制是什么、参数卡在哪、什么时候不值得做。最后给一个判断顺序,帮你决定自己的系统先动哪一个。
直传:文件为什么不该经过你的服务器
代理转发上传有三笔账,平时都不显眼,文件一大全部显形。
带宽账:文件进应用服务器再出,占用的是双倍流量。应用服务器的带宽一般是按固定带宽买的,1M 小水管传 800MB 要一个多小时,这一个多小时里同一个服务器上的所有接口都在变慢——上传把正常的业务流量挤掉了。
内存账:Spring Boot 的 spring.servlet.multipart.file-size-threshold 默认 0B,即全部落盘到临时文件,这一步本身不吃堆。吃堆的是转存那行代码——MultipartFile.getBytes() 把整个文件读成字节数组再交给 OSS SDK,两个 800MB 并发就是 1.6GB 的堆压力。换成 getInputStream() 流式转存能缓一步,但文件还是要进出应用服务器一趟,带宽账和超时账不变。
超时账:Nginx 的 proxy_read_timeout 默认 60 秒,云厂商 SLB/ALB 的默认也是 60 秒上下,前端 axios 一般配 30 到 120 秒——三道里最短的那道决定上传能撑多久。800MB 在多数客户网络里传不完这个时间,于是不断超时重试,服务端留下了半截的临时文件。
直传把这三笔账一起消掉:浏览器拿着服务端给的凭证,直接把文件放进对象存储,应用服务器只发凭证、不碰文件。两种发凭证的方式,管的事不一样:
| PostObject 表单直传 | 预签名 URL(PUT) | |
|---|---|---|
| 凭证形态 | 一组表单域(V1:OSSAccessKeyId、policy、Signature;V4:x-oss-credential、x-oss-signature 等) | 一个带签名参数的完整 URL |
| 服务端能约束什么 | key 前缀、文件大小区间(content-length-range)、过期时间、Content-Type | key、方法(PUT/GET)、过期时间 |
| 客户端能不能改约束 | 不能,policy 签了名,改了就 403 | 不能,URL 里 key 已定死 |
| 适用场景 | 浏览器表单上传,一个请求发文件加元数据 | 前端 fetch/axios 分块、或者要给第三方系统发一次性上传链接 |
| 一个请求的上限 | 表单 body 有上限(阿里云 5GB) | 单次 PUT 5GB,再大要分片 |
浏览器场景优先 PostObject:policy 是一段 Base64 的 JSON,服务端把这次允许写入的精确 key(uploads/${tenantId}/${uuid}.mp4,服务端生成,前端不参与拼路径)、大小区间、过期时间写进去,用 AccessKeySecret 对 policy 签名,浏览器带着文件和这组表单域直接 POST 到桶。policy 里用精确 key 条件而不是前缀匹配,前端改不了路径——租户隔离在签发那一刻就定住,不靠上传之后检查。
发预签名 URL 有一个不直观的坑,官方文档写得很清楚但经常被忽略:URL 的有效期受签发它所用凭证的约束。用长期凭证(控制台里建的那种 AK/SK)签,AWS SigV4 和阿里云 V4 签名都限 7 天以内(阿里云 V1 签名没有这个上限,但 V1 官方已停止维护,新项目别用);用临时凭证(STS 是各家云的临时授权服务,授权几分钟到几小时就过期)签,凭证什么时候到期,URL 就什么时候失效——你写了 7 天有效期也没用。私有化部署里用 AK/SK 的多,踩不到;上了云用了 STS 或实例角色的,凌晨签发一条 24 小时的链接给客户下载,中午凭证轮换了链接就 403,客户报「文件打不开」,查签名日志才发现是凭证先过期。
直传还有一个必须补的环节:文件进了桶,不等于进了业务系统——业务系统的附件表是 MySQL 里的 attachment,桶里的对象在对象存储里,两边各记各的账。写附件记录的触发点别放在前端:用户传完不等页面响应就关了,前端那次回调永远不会来。主路径用对象存储的服务端回调——阿里云 PostObject 和 CompleteMultipartUpload 都支持 callback 表单域,上传成功后 OSS 自己 POST 你的接口,带 key、大小、CRC64;S3 对应的是事件通知。回调也会失败(你的接口当时在重启),所以还要配一个兜底对账:定时扫桶里的对象和 attachment 表对不上的,进「孤儿文件」清单(怎么清是明天短文的话题)。订单要幂等、回调要对账,文件不是例外。
断点续传:分片协议和服务端状态
800MB 传到 95% 断网,从头再来的代价是时间和流量;更疼的是这种失败没有规律,移动办公的客户几乎天天撞。断点续传把大文件切成片,失败后只补没传完的片。
协议是三步,各家的对象存储只差名字:第一步阿里云叫 InitiateMultipartUpload、S3 和 MinIO 叫 CreateMultipartUpload,拿一个 uploadId,UploadPart 按分片号传,CompleteMultipartUpload 让服务端把片拼成对象。暂停就是不再传片,续传就是拿着 uploadId 查哪些片已经在了,接着传缺的。参数有两家可以对着看:
| 参数 | Amazon S3 | 阿里云 OSS |
|---|---|---|
| 分片大小 | 5 MiB – 5 GiB,最后一片无下限 | 100 KB – 5 GB,最后一片可小于 100 KB |
| 分片数上限 | 10,000 | 10,000 |
| 单对象上限 | 48.8 TiB | 48.8 TB |
| 未完成任务的残留 | 未完成的分片计费,建议配生命周期规则中止 | 文档原话「分片上传任务无过期时间限制」,已传分片作为碎片文件持续产生存储费用 |
MinIO 走 S3 兼容口径,私有化客户的参数照 S3 列记。
分片大小是个取舍:片切得小,单片失败重传的代价小,但请求数多、每片的固定开销(握手、签名)占比大;片切得大,请求数少,但弱网下一片传不完的概率高。经验值是按「目标 5 分钟内传完一片」估:客户带宽 10Mbps,一片给 30–50MB。别拍 100KB——100KB 是协议下限,不是推荐值,按下限切一万片,Complete 的时候合并元数据都能把服务端打挂。
断点续传真正要设计的是服务端的状态,不是客户端。uploadId 挂在对象存储那边,但「这个上传是谁发起的、哪个租户的、什么业务类型、传完归到哪个附件记录」,这些只有你的库知道:
CREATE TABLE upload_task (
  id           BIGINT      NOT NULL PRIMARY KEY,
  tenant_id    BIGINT      NOT NULL,
  biz_type     VARCHAR(32) NOT NULL,   -- video / drawing / attachment
  biz_id       BIGINT      NULL,       -- 传完才关联上的业务单据
  object_key   VARCHAR(255) NOT NULL,  -- 桶内路径,签发时定死
  file_name    VARCHAR(255) NOT NULL,
  file_size    BIGINT      NOT NULL,
  file_sha256  CHAR(64)    NULL,       -- 秒传与校验用,见下一节
  upload_id    VARCHAR(128) NOT NULL,  -- 对象存储返回的 uploadId
  part_size    BIGINT      NOT NULL,   -- 本任务的分片大小,续传时要用同一个值
  status       VARCHAR(16) NOT NULL DEFAULT 'UPLOADING',
              -- UPLOADING / COMPLETED / ABORTED / EXPIRED
  uploader_id  BIGINT      NOT NULL,
  created_at   DATETIME    NOT NULL,
  completed_at DATETIME    NULL,
  UNIQUE KEY uk_upload_id (tenant_id, upload_id),
  KEY idx_tenant_status (tenant_id, status, created_at)
);
两个设计点。part_size 落库是因为续传必须用和原任务相同的分片大小,客户端换设备、换浏览器回来,localStorage 里的设置早没了,服务端查出来告诉它——这也是为什么断点续传的状态不能只放客户端:换台电脑,续传就断片了。status 里留 EXPIRED 是给清理任务用的:传到一半放弃的任务,过了 N 天标记过期,然后调 AbortMultipartUpload 把碎片清掉,同时删本地任务行。不做这一步,碎片会一直躺在桶里计费——阿里云文档那句「无过期时间限制」翻译过来就是「你不清,它永远在,永远收费」。清理动作配成对象存储的生命周期规则兜底,应用层主动 Abort 加规则自动清,双保险。
Complete 之后还有完整性校验,这里有个常见的想当然:SHA-256 不能由分片哈希拼出整文件哈希,直传的字节又不经过应用服务器,所以「服务端在 Complete 时算一遍 SHA-256」做不到。能零成本做的是对象存储自己算的 CRC64——阿里云 Complete 响应和 HeadObject 都带 x-oss-hash-crc64ecma,客户端本地算一个 CRC64 上报,服务端比对两个值,不一致就判上传损坏。file_sha256 走另一条路:Complete 回调之后起一个异步任务,从内网 endpoint 把对象拉流算一遍再回填——内网流量不计费,但每个文件要多读一遍,量大的系统这笔 IO 要算进去。两步做完才落附件记录、把 biz_id 关联上。
秒传:指纹、复核、引用计数
断点续传解决「传不完」,秒传解决「不该传」。用户的素材库里有 300 个视频,其中 40 个去年传过;一个行业标准模板 PDF,全公司 200 个人都要传一遍。这些重复流量本来可以一分不花。
流程四步:客户端本地算文件指纹(SHA-256 加文件大小),先问服务端「这个指纹你们有吗」;有,客户端不传字节,服务端建一条引用记录,前端直接显示上传完成——这就是「秒」的全部含义;没有,走正常上传,服务端在落桶的时候把指纹登记进指纹表。
秒传的安全问题常被说成「MD5 有碰撞,换 SHA-256 就好」。这个说法把威胁模型搞反了:攻击者不需要造碰撞,只需要知道目标文件的哈希值——合同扫描件的 SHA-256 出现在日志、前端埋点、或者就是一份公开模板的已知哈希——报上这个值,秒传机制就把别人的文件挂到了他的账号下。换什么算法都不挡这一招,挡它的是两条边界。
第一条是租户:指纹表带 tenant_id,默认只在租户内去重。租户 A 传过的文件,租户 B 报同一个哈希就是没命中,老老实实传——多租户 B 端系统里这是底线,和前面 policy 里精确 key 的租户隔离是同一个原则。第二条是占有证明,只在真要跨租户去重时用:服务端下发一个随机的字节区间(offset 加 length),客户端回传这一段的哈希,服务端从桶里取同一段比对——知道整文件哈希的人不一定手里有文件,手里有文件的人才答得上随机区间。
库里的指纹本身也得是服务端算的。客户端报的 SHA-256 只当查询线索,入库的值来自上一节那个异步拉流任务——秒传跳过的是这一次的传输,但它命中的那条指纹,是上一次服务端自己算出来登记的。链条闭合的前提是客户端报的值从来不直接写进指纹表。
引用计数是秒传的隐藏成本。300 个人「上传」同一个模板,物理上是一份对象加 300 条引用,删除的语义就变成了引用减一,减到零才真删桶里的对象。用软删(deleted_at)加定时任务回收,比实时计数简单,够用。这里和 13 篇的 file_sha256 分个层:那篇的哈希是业务去重——「这份 Excel 是不是已经导入过」,落点在导入批次;这里的哈希是存储去重——「这份内容是不是已经在桶里」,落点在对象引用。两层各自的键、各自的表,别混用一张表伺候两个问题,查询模式不一样。
什么时候不该做
按痛的程度排,不动手之前先对着量一下。
文件普遍小于 10MB 的系统,直传都未必需要。表单附件、几页扫描件,走应用服务器中转,一台 4 核 8G 扛得住,引入对象存储直传反而把凭证签发、回调确认、孤儿清理这一整套复杂度提前请进来。先看文件分布:P95 在 10MB 以内,直传缓做;P95 上到 100MB 或者客户明确要传视频图纸,直传是第一优先。
断点续传跟着直传走。做了直传、文件又大,续传几乎是必选——它复用直传的凭证体系和分片参数,增量成本主要在 upload_task 表和清理任务。文件不大就没必要,切分片的开销比一次传完还贵。
秒传看重复率,不看技术。 B 端系统的文件多是合同、附件、现场照片,天然低重复,秒传的命中率在我接触过的几个项目里是个位数,整套指纹表、复核链路、引用计数换不来几个 GB。文档模板类、素材库类系统重复率高得多,秒传才划算。判断方法很土:从现有附件表抽样 1000 行,按文件大小加哈希排个重,命中率低于 10% 就先不做,这个数一天能算出来。
私有化部署用 MinIO 的,口径照 S3 记,但有一处差异要实测:分片合并的行为和阈值随版本在变,上线前拿真实文件大小跑一遍完整链路,别拿文档参数当实测结果。
上线前查什么
三件事,全是文件链路特有的:签发凭证里的 key 前缀带没带 tenant_id,这道没卡住,租户 A 的凭证能往租户 B 的路径写文件;预签名 URL 有没有整条出现在 Nginx 或应用日志里,URL 是 bearer token,进日志就是泄露面;碎片清理跑一周后,桶里的碎片目录是不是只增不减,是就说明生命周期规则没生效,去控制台核对规则的作用前缀是不是碎片所在的目录。
三个词对应三个问题。哪个先做,回到上一节那几个数:文件分布的 P95、抽样一千行的重复率、Nginx 日志里 499 和 504 的日均条数(那就是上传超时重传量),三个数哪个大,先动哪个。
系列:相关 私有桶的签名 URL 怎么发 | 主流程演示得再顺,客户还是要先导一个 Excel | 技术纵深系列索引